



تا حالا به این فکر کردی که وقتی هوش مصنوعی هم با برنامهنویسی ساخته میشه، پس چه فرقی با یک برنامه معمولی داره؟
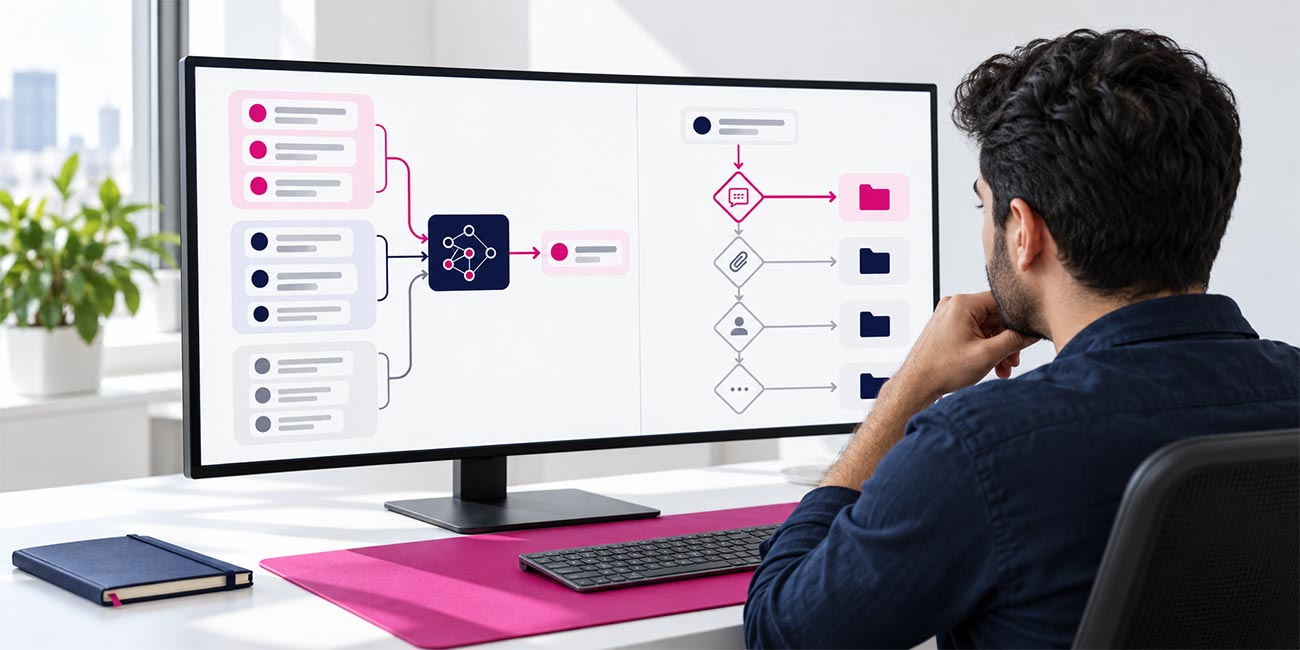
ببین، فرض کن میخوایم سیستمی بسازیم که پیامهای مشتریها رو بررسی کنه و شکایتها رو تشخیص بده.
در برنامهنویسی معمولی، خودمون قانون مینویسیم.
اما اگر مشتری بنویسه «تعمیرکار اومد، ولی دستگاه هنوز خرابِ»، چی؟ اینجا دیگه خبری از کلمه شکایت نیست.
پس برنامه از کجا بفهمه مشتری ناراضیه؟
اینجاست که یادگیری ماشین به کارمون میاد. بهجای نوشتن قانون برای تمام جملههای ممکن، نمونههایی از پیامهای مشتریها رو به مدل میدیم تا یاد بگیره چه پیامهایی نشونه نارضایتی هستن.
حالا احتمالاً میپرسی: «مگه این یادگرفتن هم با برنامهنویسی انجام نمیشه؟ پس تفاوت دقیقاً کجاست؟»
سؤال اصلی همینجاست. بیا در ادامه این مقاله از آکادمی پاکراه، از همین نقطه شروع کنیم و ببینیم پشت صحنه هر روش چه اتفاقی میافته.
- تفاوت هوش مصنوعی و برنامهنویسی در یک نگاه
- برنامهنویسی قانونمحور چگونه کار میکند؟
- هوش مصنوعی چگونه مسئله را حل میکند؟
- یک مسئله، دو راهحل؛ تفاوت هوش مصنوعی و برنامهنویسی با مثال
- تفاوت هوش مصنوعی و برنامهنویسی در خطا، دقت و نگهداری چیست؟
- هوش مصنوعی چه ارتباطی با برنامهنویسی دارد؟
- چه زمانی برنامهنویسی و چه زمانی هوش مصنوعی مناسبتر است؟
- آیا برای استفاده از هوش مصنوعی باید برنامهنویسی بلد باشیم؟
- آیا هوش مصنوعی جای برنامهنویسان را میگیرد؟
- جمعبندی
تفاوت هوش مصنوعی و برنامهنویسی در یک نگاه
بیا برگردیم به همون مثال پیام مشتری. قرار بود سیستمی بسازیم که تشخیص بده کدوم پیام شکایته.
در برنامهنویسی قانونمحور، خودمون شرط میذاریم. مثلاً به برنامه میگیم اگر پیام شامل کلمه «شکایت» بود، اون رو در گروه شکایتها قرار بده.
اما مشتریها همیشه از یک جمله مشخص استفاده نمیکنن. یکی مینویسه «از خدماتتون ناراضیام» و یکی دیگه میگه «تعمیرکار اومد، ولی مشکل هنوز برطرف نشده».
حالا میتونیم برای هر عبارت یک قانون جدید بنویسیم، اما آیا میتونیم تمام جملههایی رو که مشتریها ممکنه بنویسن، از قبل حدس بزنیم؟
اینجاست که یادگیری ماشین به کمکمون میاد.
بهجای اینکه همه عبارتها رو خودمون تعریف کنیم، یک مدل میسازیم و نمونههایی از پیامهای شکایت و غیرشکایت رو بهش میدیم.
مدل در شروع ممکنه پیامها رو اشتباه تشخیص بده. اما در جریان آموزش، جوابهای مدل با جوابهای درست مقایسه میشن و الگوریتم آموزش، عددهایی رو در مدل تغییر میده تا اشتباهاتش کمتر بشن.
به این عددهای قابلتغییر پارامتر (Parameter) میگیم. این عددها روی نتیجه محاسبات مدل اثر میذارن.
پس تفاوت کجاست؟
- در برنامهنویسی قانونمحور، ما شرطهای تصمیمگیری رو مستقیماً مینویسیم.
- در یادگیری ماشین، کدِ ساخت و آموزش مدل رو مینویسیم،
- اما بسیاری از رابطههایی که مدل برای تصمیمگیری استفاده میکنه، در زمان آموزش و از روی دادهها شکل میگیرن.
برای اینکه تفاوتها رو راحتتر ببینی، این جدول رو بررسی کن:
| معیار | برنامهنویسی قانونمحور | هوش مصنوعی یادگیرنده |
|---|---|---|
| روش تصمیمگیری | اجرای شرطهای نوشتهشده | استفاده از رابطههای آموختهشده |
| نقش برنامهنویس | تعیین مستقیم قوانین | ساخت مدل و روش آموزش |
| نقش داده | اطلاعات موردنیاز برنامه | نمونههای آموزشی و ورودی جدید |
| تغییر رفتار | معمولاً با تغییر قوانین | با تنظیم مدل یا آموزش دوباره |
| اشتباهات | باگ یا قانون نامناسب | باگ یا پیشبینی اشتباه |
| بررسی عملکرد | آزمایش قوانین و شرایط | ارزیابی با دادههای جدید |
| توضیح نتیجه | معمولاً سادهتر | گاهی دشوارتر |
اما یک سؤال مهم باقی میمونه:
اگر هوش مصنوعی از دادهها یاد میگیره، پس چرا بعضی از سیستمهای قدیمی هوش مصنوعی بدون یادگیری هم کار میکردن؟
چون هوش مصنوعی و یادگیری ماشین دقیقاً یک چیز نیستن.
برای مثال، سیستمهای خبره (Expert Systems) میتونن براساس قوانین مشخصی که انسان نوشته، تصمیم بگیرن. این سیستمها هم بخشی از تاریخ و فناوری هوش مصنوعی هستن.
آرتور ساموئل (Arthur Samuel)، از پیشگامان یادگیری ماشین، در سال ۱۹۵۹ روی برنامهای کار کرد که با تجربه بازی چکرز، عملکردش بهتر میشد. تعریف مشهوری هم به او نسبت داده شده که میگه یادگیری ماشین به کامپیوتر توانایی یادگرفتن میده، بدون اینکه تمام رفتارهاش مستقیم برنامهنویسی شده باشن.
پس وقتی در این مقاله درباره تفاوت قانوننویسی و یادگیری از داده صحبت میکنیم، منظورمون مقایسه برنامهنویسی قانونمحور با هوش مصنوعی مبتنی بر یادگیری ماشین است.
حالا که تفاوت کلی رو فهمیدیم، بریم ببینیم وقتی یک برنامهنویس شرطی مینویسه، کامپیوتر دقیقاً چطور اون رو اجرا میکنه.
برنامهنویسی قانونمحور چگونه کار میکند؟
حالا که تفاوت کلی رو فهمیدیم، بیا ببینیم وقتی یک برنامهنویس برای کامپیوتر قانون مینویسه، دقیقاً چه اتفاقی میافته.
فرض کن به یکی از کارمندهای شرکت میگی: «اگر مشتری هزینه تعمیر رو پرسید، راهنمای قیمت رو براش بفرست. اگر درخواست ثبت کرده بود، وضعیت سفارش رو بررسی کن.»
اینجا تو از قبل مشخص کردی که کارمند در هر شرایطی چه کاری انجام بده. حالا اگر همین دستورها رو به زبان برنامهنویسی بنویسیم، کامپیوتر هم میتونه اونها رو اجرا کنه.
منطق اگر، آنگاه و در غیر این صورت چیست؟
یکی از سادهترین روشها برای نوشتن چنین دستورهایی، استفاده از شرطهای If / Then / Else است؛
- یعنی «اگر این اتفاق افتاد، این کار رو انجام بده؛ در غیر این صورت، کار دیگهای بکن».
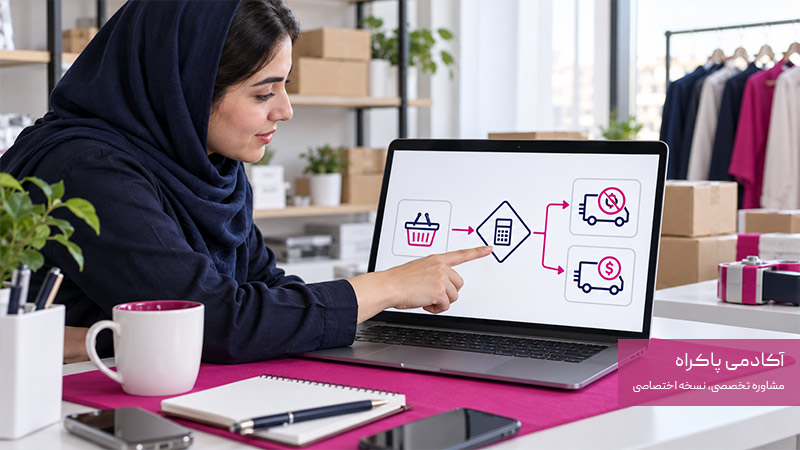
مثلاً فرض کن میخوایم برای سفارشهای یک فروشگاه، هزینه ارسال رو محاسبه کنیم.
به برنامه میگیم:
- اگر مبلغ سفارش بیشتر از یک میلیون تومان بود، ارسال رایگان باشه.
- در غیر این صورت، ۵۰ هزار تومان هزینه ارسال اضافه بشه.
حالا مشتری یک سفارش ۱ میلیون و ۲۰۰ هزار تومانی ثبت میکنه. برنامه مبلغ رو بررسی میکنه، شرط اول برقرار میشه و هزینه ارسال رو صفر در نظر میگیره.
برای این کار لازم نیست برنامه قبلاً هزاران سفارش دیده باشه یا چیزی یاد بگیره. فقط قانونی رو اجرا میکنه که براش نوشتیم.
اما یک نکته مهم وجود داره:
کامپیوتر خودش تشخیص نمیده که قانون ما برای کسبوکار مناسبه یا نه.
اگر اشتباهی نوشته باشیم سفارشهای کمتر از یک میلیون تومان رایگان ارسال بشن، برنامه ممکنه همون قانون اشتباه رو بدون هیچ مشکلی اجرا کنه.
پس درست اجراشدن کد همیشه به معنی درستبودن تصمیم ما نیست.
یک نمونه واقعی از برنامهنویسی قانونمحور در کسبوکار
حالا میخوام یک نمونه از سیستمسازی در آیپی امداد رو توضیح بدم.
وقتی سفارشی به متخصص اختصاص پیدا میکنه، نمیتونیم منتظر بمونیم تا هر زمان که خواست وضعیت سفارش رو مشخص کنه. باید یک فرایند مشخص داشته باشیم تا درخواست مشتری بدون پیگیری باقی نمونه.
برای همین، در این فرایند چند قانون تعریف شده:
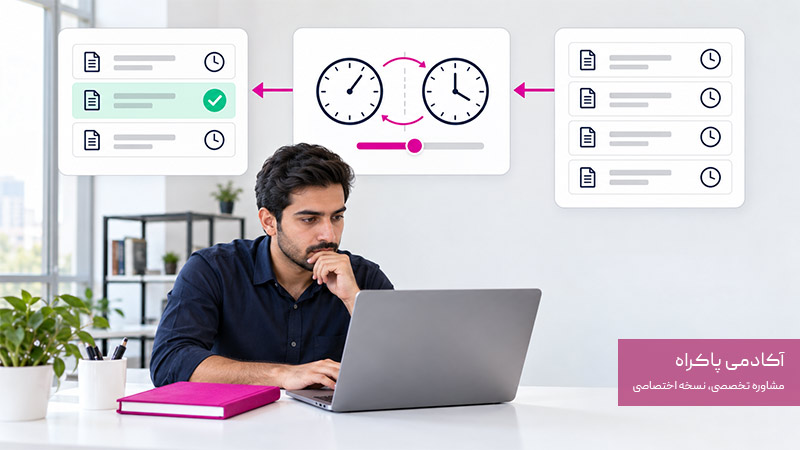
- متخصص حداکثر یک ساعت فرصت داره وضعیت سفارش رو مشخص کنه.
- اگر اقدامی نکنه، ۱۵ دقیقه بعد پیامک یادآوری براش ارسال میشه.
- اگر همچنان پاسخی نده، ۱۰ دقیقه بعد تلفن گویا باهاش تماس میگیره.
- اگر باز هم وضعیت سفارش مشخص نشه، درخواست به متخصص دیگهای ارسال میشه.
دقت کن چه اتفاقی افتاده. ما از قبل مشخص کردیم در هر مرحله، تحت چه شرایطی چه کاری انجام بشه.
سیستم هم وضعیت سفارش و زمان سپریشده رو بررسی میکنه و براساس همین قوانین جلو میره.
این یک سیستم قانونمحوره، نه یک مدل هوش مصنوعی.
اما آیا میشه همین کار رو با هوش مصنوعی هم انجام داد؟ مثلاً بهجای اینکه فقط منتظر گذشت یک ساعت بمونیم، از قبل پیشبینی کنیم کدوم سفارش احتمال بیشتری داره با تأخیر روبهرو بشه؟
بله، اگر اطلاعات مناسب داشته باشیم، میتونیم مدلی برای چنین پیشبینیای آموزش بدیم. البته این فقط یک مثال فرضیه و به معنی استفاده از چنین مدلی در آیپی امداد نیست.
اینجاست که تفاوت دو روش جالبتر میشه:
- در یکی ما شرایط تصمیمگیری رو از قبل مینویسیم؛
- در دیگری میتونیم از دادههای گذشته برای پیشبینی شرایط جدید کمک بگیریم.
حالا سؤال بعدی اینه: چطور به کامپیوتر یاد میدیم چیزی رو پیشبینی کنه، وقتی خودمون قانون دقیق اون پیشبینی رو نمیدونیم؟
برای جوابدادن به این سؤال، باید سراغ نحوه کار مدلهای یادگیری ماشین بریم.
هوش مصنوعی چگونه مسئله را حل میکند؟
تا اینجا فهمیدیم که در برنامهنویسی قانونمحور، خودمون به کامپیوتر میگیم در هر شرایط چه کاری انجام بده. اما درباره هوش مصنوعی گفتیم که میتونه از دادهها یاد بگیره.
- خب، این یادگرفتن دقیقاً یعنی چی؟
- مگه کامپیوتر مثل انسان فکر میکنه که چیزی رو یاد بگیره؟
نه. وقتی میگیم یک مدل هوش مصنوعی یاد میگیره، منظورمون اینه که کامپیوتر یکسری محاسبات انجام میده و عددهای داخل مدل رو طوری تغییر میده که نتیجه بهتری بگیره.
حالا بیا ببینیم این اتفاق چطور میافته.
اول ببینیم مدل هوش مصنوعی رو چطور میسازیم
فرض کن میخوایم سیستمی بسازیم که پیشبینی کنه یک متخصص چند دقیقه بعد از دریافت سفارش، وضعیت اون رو مشخص میکنه.
از سفارشهای قبلی هم اطلاعات داریم. مثلاً میدونیم متخصص در زمان دریافت هر سفارش، چند درخواست دیگه داشته و بعد از چند دقیقه پاسخ داده.
حالا میخوایم بررسی کنیم آیا بین تعداد سفارشهای همزمان و زمان پاسخگویی رابطهای وجود داره یا نه.
در برنامهنویسی قانونمحور میتونیم خودمون بنویسیم:
«اگر متخصص بیشتر از ۵ سفارش داشت، زمان پاسخگویی رو ۶۰ دقیقه در نظر بگیر.»
اما از کجا معلوم این قانون درست باشه؟ شاید یک متخصص با ۸ سفارش هم سریع پاسخ بده و متخصص دیگه با ۳ سفارش دیرتر جواب بده.
اینجاست که میخوایم بهجای تعیین یک قانون ثابت، از اطلاعات سفارشهای قبلی کمک بگیریم.
برای اینکه نحوه کار رو بفهمیم، فعلاً یک مدل خیلی ساده میسازیم.
مدل ما فقط یک محاسبه داره:
تعداد سفارشهای همزمان × یک عدد قابلتغییر = زمان پیشبینیشده پاسخگویی
به اون عدد قابلتغییر، وزن (Weight) میگیم.
این وزن، یکی از پارامترهای مدله؛ یعنی عددی که میتونه هنگام آموزش تغییر کنه و روی نتیجه اثر بذاره.
مثلاً فرض کن وزن رو در ابتدا روی ۱۰ گذاشتیم.
اگر متخصص ۳ سفارش داشته باشه، مدل این محاسبه رو انجام میده:
۳ × ۱۰ = ۳۰ دقیقه
پس مدل زمان پاسخگویی رو ۳۰ دقیقه پیشبینی میکنه.
دقت کن، مدل چیزی رو از خودش حدس نزده. فقط یک فرمول رو اجرا کرده که ما ساختیم و از عددی استفاده کرده که فعلاً داخل مدل قرار داره.
البته مدلهای واقعی میتونن ورودیهای بیشتر و محاسبات بسیار پیچیدهتری داشته باشن. این مثال رو عمداً ساده کردیم تا اصل یادگیری رو ببینیم.
حالا کامپیوتر چطور میفهمه پیشبینیاش اشتباه بوده؟
فرض کن از اطلاعات سفارشهای قبلی میدونیم متخصصی که ۳ سفارش همزمان داشته، در واقع بعد از ۴۵ دقیقه پاسخ داده.
پس دو عدد داریم:
- پیشبینی مدل: ۳۰ دقیقه
- زمان واقعی پاسخگویی: ۴۵ دقیقه
مدل ۱۵ دقیقه کمتر از مقدار واقعی پیشبینی کرده.
حالا سؤال اینه:
کامپیوتر چطور این اشتباه رو پیدا میکنه؟
ما در کد مشخص میکنیم که نتیجه پیشبینی با مقدار واقعی مقایسه بشه.
در مثال ساده ما، اختلاف رو اینطور محاسبه میکنیم:
- ۴۵ − ۳۰ = ۱۵ دقیقه
اینجا هنوز هیچ یادگیریای اتفاق نیفتاده. کامپیوتر فقط فهمیده بین پیشبینی و جواب درست، ۱۵ دقیقه اختلاف وجود داره.
الگوریتم آموزش چطور عددهای مدل رو تغییر میده؟
یادت هست وزن مدل رو روی ۱۰ گذاشتیم؟
همین عدد باعث شد برای ۳ سفارش، زمان ۳۰ دقیقه به دست بیاد.
حالا میخوایم ببینیم اگر وزن رو تغییر بدیم، نتیجه چه اتفاقی میافته.
فرض کن وزن رو از ۱۰ به ۱۲ افزایش بدیم:
۳ × ۱۲ = ۳۶ دقیقه
نتیجه به زمان واقعی ۴۵ دقیقه نزدیکتر شد.
اگر وزن به ۱۴ برسه:
۳ × ۱۴ = ۴۲ دقیقه
حالا فقط ۳ دقیقه اختلاف داریم.
و اگر وزن ۱۵ بشه:
۳ × ۱۵ = ۴۵ دقیقه
مدل برای این نمونه دقیقاً به جواب درست میرسه.
| وزن مدل | زمان پیشبینیشده | اختلاف با واقعیت |
|---|---|---|
| ۱۰ | ۳۰ دقیقه | ۱۵ دقیقه |
| ۱۲ | ۳۶ دقیقه | ۹ دقیقه |
| ۱۴ | ۴۲ دقیقه | ۳ دقیقه |
| ۱۵ | ۴۵ دقیقه | صفر |
شاید الان بپرسی:
«خب، این عددها رو که خودمون تغییر دادیم. پس هوش مصنوعی چی کار کرد؟»
این سؤال دقیقاً همون چیزیه که باید روشن بشه.
ما برای یادگرفتن موضوع، وزنها رو دستی تغییر دادیم. اما در آموزش واقعی، یک الگوریتم این تغییرات رو با محاسبات ریاضی انجام میده.
یعنی برنامهنویس به کامپیوتر نمیگه «وزن نهایی باید ۱۵ باشه». برنامهنویس روش محاسبه خطا و اصلاح وزن رو مشخص میکنه.
بعد کامپیوتر با اجرای همون روش روی نمونههای آموزشی، وزنهای مناسبتری پیدا میکنه.
آیا پیدا کردن جواب درست برای یک نمونه یعنی مدل آموزش دیده؟
نه لزوماً.
ما در مثال بالا فقط یک نمونه داشتیم. اگر وزن رو طوری تنظیم کنیم که نتیجه همین یک سفارش درست بشه، هنوز نمیدونیم مدل برای سفارشهای دیگه هم خوب کار میکنه یا نه.
برای همین باید مدل رو با نمونههای مختلف آموزش بدیم و بعد با اطلاعاتی که قبلاً ندیده آزمایشش کنیم.
پس تفاوت یادگیری ماشین با برنامهنویسی معمولی دقیقاً کجاست؟
حالا میتونیم جواب سؤال اول رو روشنتر بدیم.
در برنامهنویسی قانونمحور، ممکنه خودمون بنویسیم:
«اگر تعداد سفارشها ۳ بود، زمان پاسخگویی رو ۴۵ دقیقه در نظر بگیر.»
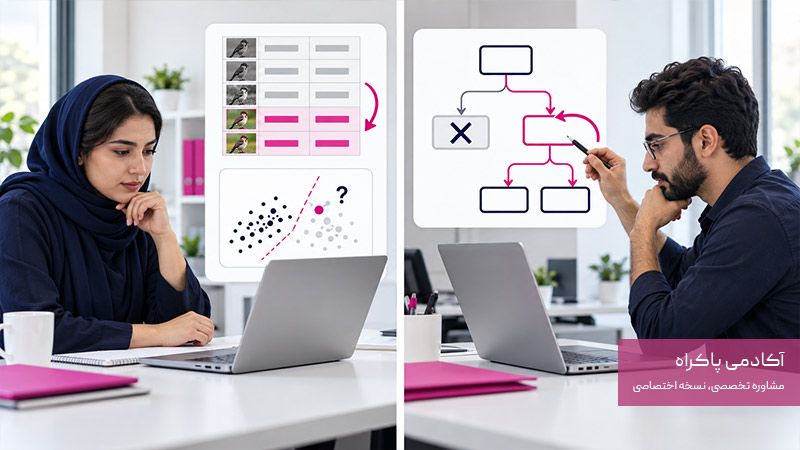
اما در مدل یادگیری ماشین، ما فرمول، ساختار مدل و روش آموزش رو مشخص میکنیم. بعد با استفاده از اطلاعات قبلی، الگوریتم آموزش عددهای داخل مدل رو تنظیم میکنه.
پس در هر دو روش برنامهنویسی داریم، اما نقش کد یکسان نیست.
- در روش اول، قانون تصمیمگیری رو مستقیم مینویسیم.
- در روش دوم، روش یادگیری رو برنامهنویسی میکنیم تا مدل با استفاده از دادهها، تنظیمات مناسب رو پیدا کنه.
البته این به معنی برتری همیشگی یادگیری ماشین نیست. حتی ممکنه یک قانون ساده برای مسئله ما مناسبتر و دقیقتر باشه.
مگر هوش مصنوعی قانونمحور هم داریم؟
حالا شاید بگی: «پس اگر یک سیستم فقط قانونهای نوشتهشده رو اجرا کنه، دیگه نمیتونه هوش مصنوعی باشه؟»
چرا، میتونه.
در هوش مصنوعی روشهایی وجود دارن که بر پایه قوانین نوشتهشده توسط انسان کار میکنن. یکی از نمونههای شناختهشده اونها سیستمهای خبره (Expert Systems) هستن.
در این سیستمها، دانش متخصصان به شکل قانونهایی وارد برنامه میشه تا سیستم بتونه با بررسی شرایط، نتیجهگیری کنه.
ما در این مقاله از آکادمی پاکراه، برنامهنویسی قانونمحور رو با هوش مصنوعی یادگیرنده مقایسه میکنیم تا تفاوت روش حل مسئله رو بهتر بفهمیم.
حالا که دیدیم هر دو روش چطور ساخته میشن، بیا یک مسئله یکسان رو با هر دو حل کنیم و نتیجه رو کنار هم ببینیم.
یک مسئله، دو راهحل؛ تفاوت هوش مصنوعی و برنامهنویسی با مثال
تا اینجا دیدیم چطور میتونیم با برنامهنویسی، قانون مشخص کنیم یا مدلی بسازیم که از دادهها یاد بگیره. حالا بیا یک مسئله یکسان رو با هر دو روش حل کنیم تا تفاوتشون رو بهتر ببینیم.
فرض کن روزانه صدها پیام به بخش پشتیبانی یک فروشگاه اینترنتی میرسه. بعضی مشتریها درباره قیمت سؤال دارن، بعضی وضعیت سفارش رو میخوان و بعضی هم از خدمات ناراضی هستن.
ما میخوایم سیستمی بسازیم که پیامهای شکایت رو تشخیص بده تا زودتر بررسی بشن.
راهحل اول: تشخیص شکایت با برنامهنویسی قانونمحور
اول سراغ روش سادهتر میریم.
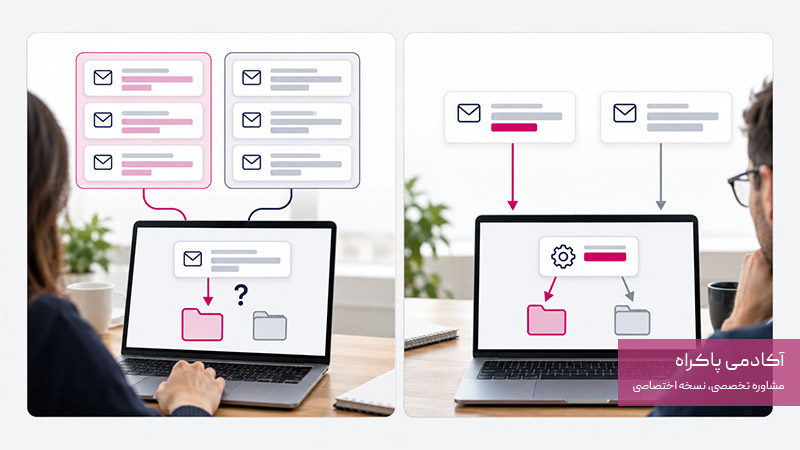
به برنامه میگیم اگر پیام مشتری شامل کلماتی مثل «شکایت»، «ناراضی» یا «خراب» بود، اون رو در گروه شکایتها قرار بده.
حالا این پیام رو دریافت میکنیم:
«از خدماتتون ناراضیام.»
برنامه کلمه «ناراضی» رو پیدا میکنه و پیام رو در گروه شکایتها قرار میده.
تا اینجا همهچیز خوب پیش رفته. اما مشتری بعدی مینویسه:
«سه روزه منتظر سفارشم هستم، هنوز به دستم نرسیده.»
این مشتری هم ناراضیه، اما هیچکدوم از کلماتی که مشخص کردیم در پیامش نیست.
خب، چه کار کنیم؟
میتونیم کلماتی مثل «منتظر» و «نرسیده» رو هم به قانونها اضافه کنیم.
اما مشکل جدیدی پیش میاد. ممکنه مشتری بنویسه:
«ممنون که نذاشتید بیشتر منتظر بمونم.»
اگر فقط دنبال کلمه «منتظر» بگردیم، این پیام تشکر رو هم ممکنه شکایت تشخیص بدیم.
پس برای دقیقترشدن سیستم، باید قوانین بیشتری بنویسیم و حالتهای مختلف جملهها رو در نظر بگیریم.
این روش برای شرایط ساده و مشخص میتونه خوب کار کنه، اما وقتی پیامها شکلهای متنوعی دارن، نوشتن و نگهداری تمام قوانین سختتر میشه.
راهحل دوم: تشخیص شکایت با یادگیری ماشین
حالا فرض کن بهجای نوشتن قانون برای هر کلمه، هزاران پیام قبلی مشتریها رو داریم.
برای هر پیام هم مشخص شده که شکایت بوده یا نه.
ما این اطلاعات رو برای آموزش یک مدل آماده میکنیم.
اما یک سؤال:
اگر هیچ قانونی درباره کلمه «نرسیده» ننویسیم، مدل از کجا میفهمه ممکنه نشونه نارضایتی باشه؟
بیا مسیر رو دنبال کنیم.
ابتدا پیامها به بخشهای کوچکتری تقسیم میشن و به شکل عددی درمیآن تا مدل بتونه اونها رو پردازش کنه.
بعد مدل با استفاده از محاسبات خودش بررسی میکنه که هر پیام چقدر به گروه شکایتها نزدیکه.
فرض کن برای پیام «سه روزه منتظر سفارشم هستم» در شروع آموزش، احتمال شکایت رو ۳۰ درصد محاسبه کنه.
این عدد به معنی احساس یا حدس انسانی نیست؛ خروجی محاسبات مدله.
ما از قبل میدونیم که این پیام یک شکایته. پس الگوریتم آموزش میتونه اختلاف پیشبینی با جواب درست رو محاسبه کنه و پارامترهای مدل رو تغییر بده.
با تکرار آموزش روی پیامهای مختلف، مدل ممکنه یاد بگیره که عبارتهایی مانند «هنوز نرسیده»، وقتی درباره سفارش مشتری استفاده میشن، اغلب با نارضایتی ارتباط دارن.
حالا اگر پیام جدیدی دریافت کنه که دقیقاً شبیه نمونههای قبلی نیست، باز هم میتونه احتمال شکایتبودن اون رو محاسبه کنه.
البته این احتمال همیشه درست نیست. مدل ممکنه پیام تشکر رو شکایت تشخیص بده یا شکایت واقعی رو از دست بده.
کدام روش نتیجه بهتری دارد؟
شاید انتظار داشته باشی بگم هوش مصنوعی همیشه بهتره، اما اینطور نیست.
فرض کن فقط میخوایم پیامهایی رو پیدا کنیم که شماره سفارش ندارن. اینجا یک قانون ساده کافی است. نیازی نیست برای چنین کاری مدل هوش مصنوعی آموزش بدیم.
اما وقتی میخوایم منظور مشتری رو از جملههای مختلف تشخیص بدیم، نوشتن قانون برای تمام حالتها دشوار میشه. اینجا یک مدل یادگیری ماشین مناسب، در صورت داشتن داده کافی و آموزش درست، میتونه کمک بیشتری بکنه.
پس قبل از انتخاب روش باید از خودمون بپرسیم:
آیا میتونیم شرایط تصمیمگیری رو با چند قانون روشن مشخص کنیم یا لازمه سیستم رابطههای پیچیدهتری رو از نمونهها یاد بگیره؟
یک نکته دیگه هم وجود داره.
- حتی وقتی از هوش مصنوعی استفاده میکنیم، باز هم به برنامهنویسی نیاز داریم.
- کسی باید پیام رو دریافت کنه، به مدل بده، نتیجه رو بررسی کنه و مشخص کنه با پیام مشتری چه کاری انجام بشه.
- یعنی قرار نیست با اضافهکردن هوش مصنوعی، برنامهنویسی حذف بشه.
در ادامه دقیقتر بررسی میکنیم که این دو روش از نظر خطا، آزمایش و نگهداری چه تفاوتهایی دارن؛ چون انتخاب یک راهحل فقط به این بستگی نداره که امروز جواب درستی بده، بلکه باید بدونیم فردا هم چطور میتونیم به عملکردش اعتماد کنیم.
تفاوت هوش مصنوعی و برنامهنویسی در خطا، دقت و نگهداری چیست؟
حالا فرض کن هر دو سیستمی که ساختیم، شروع به کار کردن. یکی با قانونهایی که خودمون نوشتیم پیامهای شکایت رو تشخیص میده و دیگری با مدلی که از پیامهای قبلی آموزش دیده.
چند روز میگذره و متوجه میشیم بعضی پیامها اشتباه دستهبندی شدن.
خب، حالا باید چیکار کنیم؟ آیا در هر دو سیستم دنبال یک مشکل میگردیم؟
نه لزوماً. چون درست اجراشدن یک برنامه با درستبودن نتیجهای که تولید میکنه، دو موضوع متفاوته.
تفاوت باگ نرمافزاری با پیشبینی اشتباه مدل
بیا اول سراغ برنامه قانونمحور بریم.
فرض کن به برنامهنویس گفتیم:
«اگر پیام مشتری شامل کلمه ناراضی بود، اون رو در گروه شکایتها قرار بده.»
اما برنامهنویس موقع نوشتن کد اشتباه میکنه و بهجای «ناراضی»، کلمه «راضی» رو مینویسه.
حالا مشتری پیام میده:
«از خدمات شما راضی هستم.»
برنامه کلمه «راضی» رو پیدا میکنه و پیام رو در گروه شکایتها قرار میده!
درحالیکه مشتری اصلاً شکایتی نداشته.
اینجا با یک باگ (Bug) روبهرو هستیم؛ چون کدی که نوشته شده، با چیزی که قرار بوده انجام بده فرق داره.
حالا یک حالت دیگه رو تصور کن.
این بار برنامهنویس کد رو درست نوشته:
«اگر پیام شامل کلمه ناراضی بود، اون رو شکایت حساب کن.»
اما مشتری مینویسه:
«تعمیرکار اومد، ولی دستگاه همچنان خراب مونده.»
برنامه این پیام رو شکایت تشخیص نمیده، چون کلمه «ناراضی» داخلش نیست.
اینجا چه اتفاقی افتاده؟
برنامه درست کار کرده، اما قانونی که ما تعریف کردیم کافی نبوده.
پس هر نتیجه اشتباهی به معنی وجود باگ نیست. گاهی خود قانونی که برای حل مسئله نوشتیم، ناقص یا نامناسبه.
حالا همین موضوع رو در مدل هوش مصنوعی بررسی کنیم.
فرض کن مدل پیام «تعمیرکار اومد، ولی دستگاه همچنان خراب مونده» رو دریافت میکنه و احتمال شکایتبودن اون رو ۲۰ درصد محاسبه میکنه.
ما هم از قبل مشخص کردیم که اگر این احتمال بیشتر از ۵۰ درصد بود، پیام در گروه شکایتها قرار بگیره.
پس مدل این پیام رو شکایت تشخیص نمیده، درحالیکه مشتری واقعاً ناراضیه.
آیا حتماً کدنویسی اشتباه بوده؟
نه. ممکنه تمام کدها درست اجرا شده باشن، اما مدل هنوز نتونسته باشه رابطه میان این نوع جملهها و نارضایتی مشتری رو بهخوبی یاد بگیره.
اینجا با خطای پیشبینی مدل روبهرو هستیم.
البته مدلهای هوش مصنوعی هم ممکنه باگ نرمافزاری داشته باشن. تفاوت اینه که برای پیدا کردن علت اشتباه، باید هم کد رو بررسی کنیم و هم عملکرد مدل رو.
تفاوت روش تست نرمافزار و ارزیابی مدل
حالا یک سؤال مهمتر:
قبل از اینکه این سیستمها رو برای پاسخگویی به مشتریها استفاده کنیم، چطور مطمئن بشیم درست کار میکنن؟
در برنامه قانونمحور، میتونیم شرایط مختلف رو آزمایش کنیم.
مثلاً بررسی کنیم:
- اگر مشتری کلمه «ناراضی» رو نوشت، آیا پیام به بخش شکایتها میره؟
- اگر مشتری فقط نوشته بود «راضی هستم»، آیا برنامه اون رو بهاشتباه شکایت حساب میکنه؟
- اگر پیام خالی بود، برنامه چه کاری انجام میده؟
با این آزمایشها میفهمیم آیا برنامه طبق قوانین موردنظر ما کار میکنه یا نه.
اما یک نکته رو فراموش نکن:
حالا بریم سراغ مدل یادگیری ماشین.
اینجا فقط بررسی اینکه کد بدون خطا اجرا میشه، کافی نیست. باید ببینیم مدل با پیامهایی که قبلاً ندیده چقدر درست کار میکنه.
فرض کن ۱۰۰ پیام جدید داریم که از قبل میدونیم کدومها شکایت هستن و کدومها نیستن.
مدل ۸۵ پیام رو درست دستهبندی میکنه و ۱۵ پیام رو اشتباه.
یعنی در این آزمایش، دقت کلی مدل ۸۵ درصد بوده.
اما صبر کن! آیا همین عدد برای اعتمادکردن به مدل کافیه؟
نه لزوماً.
فرض کن از اون ۱۰۰ پیام، فقط ۱۰ پیام شکایت واقعی بوده. حالا اگر مدل تمام پیامها رو «غیرشکایت» تشخیص بده، باز هم ۹۰ پیام رو درست دستهبندی کرده!
یعنی دقت کلی به ۹۰ درصد رسیده، اما مدل حتی یک شکایت واقعی رو هم پیدا نکرده.
پس فقط درصد دقت مهم نیست. باید ببینیم مدل چه اشتباهاتی میکنه و اون اشتباهها چه اثری روی کسبوکار دارن.
برای یک شرکت خدماتی، تشخیصندادن شکایت واقعی مشتری ممکنه خیلی مهمتر از این باشه که چند پیام عادی اشتباهی برای بررسی بیشتر فرستاده بشن.
تغییر قوانین و آموزش دوباره مدل چه تفاوتی دارند؟
حالا فرض کن بعد از مدتی، مشتریها شروع میکنن از جملههای جدیدی برای بیان نارضایتی استفاده کنن.
در برنامه نویسی قانونمحور، میتونیم قوانین جدید اضافه کنیم یا شرطهای قبلی رو تغییر بدیم.
مثلاً مشخص کنیم پیامهایی که عبارت «هنوز درست نشده» دارن هم برای بررسی به بخش شکایتها ارسال بشن.
اما در یادگیری ماشین ماجرا کمی فرق داره.
ممکنه لازم باشه پیامهای جدید رو جمعآوری کنیم، مشخص کنیم کدومها شکایت هستن و دوباره عملکرد مدل رو بررسی کنیم.
اگر مدل با این پیامها خوب کار نکنه، میتونیم با استفاده از دادههای مناسب، دوباره آموزش ببینیمش یا روش پردازش و دستهبندی رو اصلاح کنیم.
البته همیشه آموزش دوباره لازم نیست. گاهی تغییر تنظیمات سیستم یا اصلاح دادههای ورودی هم میتونه مشکل رو برطرف کنه.
حالا یک تفاوت دیگه هم وجود داره.
در برنامه قانونمحور، معمولاً راحتتر میتونیم توضیح بدیم چرا یک تصمیم گرفته شده.
مثلاً میگیم: «چون کلمه ناراضی در پیام وجود داشت، برنامه اون رو به بخش شکایتها فرستاد.»
اما در بعضی مدلهای هوش مصنوعی، تعداد زیادی پارامتر در محاسبه نتیجه نقش دارن. برای همین، ممکنه نتونیم به همین سادگی توضیح بدیم چرا مدل یک پیام رو شکایت تشخیص داده.
البته همه مدلها پیچیده نیستن. بعضی از مدلهای یادگیری ماشین هم تصمیمهای قابلتوضیحی دارن.
آیا یک سیستم که امروز درست کار میکنه، همیشه قابلاعتماده؟
نه لزوماً.
ممکنه قوانین کسبوکار تغییر کنن یا مشتریها رفتار متفاوتی پیدا کنن.
برای همین، چه از برنامهنویسی قانونمحور استفاده کنیم و چه از یادگیری ماشین، باید عملکرد سیستم رو بررسی کنیم.
تفاوت در اینه که گاهی باید کد و قوانین رو اصلاح کنیم و گاهی لازم میشه دادهها، تنظیمات یا آموزش مدل رو تغییر بدیم.
حالا احتمالاً یک سؤال دیگه برات پیش اومده: وقتی ساخت، آموزش و حتی بررسی مدل هوش مصنوعی به کد نیاز داره، پس چرا بعضیها هوش مصنوعی و برنامهنویسی رو دو چیز جدا از هم میدونن؟
برای جواب، باید رابطه واقعی این دو رو روشن کنیم.
هوش مصنوعی چه ارتباطی با برنامهنویسی دارد؟
تا اینجا دیدیم که حتی وقتی یک مدل از دادهها یاد میگیره، باز هم پشت اون برنامهنویسی وجود داره.
اما یک تفاوت مهم هست که شاید هنوز برات سؤال باشه:
اگر هوش مصنوعی با کد ساخته میشه، چرا میگیم برنامهنویسی و هوش مصنوعی یک چیز نیستن؟
ببین، برنامهنویسی یک روش برای ساخت نرمافزاره؛ اما هوش مصنوعی حوزهایه که تلاش میکنه سیستمهایی بسازه که کارهایی مثل تشخیص، پیشبینی و تصمیمگیری رو انجام بدن.
برای ساخت چنین سیستمهایی هم از برنامهنویسی استفاده میکنیم.
مثلاً برنامهنویس میتونه با زبانی مثل پایتون (Python)، کدی بنویسه که دادهها رو آماده کنه، مدل رو آموزش بده و از نتیجه اون استفاده کنه.
اما تمام بخشهای یک محصول هوش مصنوعی لزوماً هوشمند نیستن.
فرض کن وارد یک ابزار هوش مصنوعی میشی و سؤالی میپرسی.
بخش ورود به حساب کاربری، ذخیره تنظیمات، نمایش پیامها و مدیریت دسترسیها میتونن با برنامهنویسی معمولی ساخته شده باشن. در کنار اونها، یک مدل هوش مصنوعی هم درخواستت رو پردازش میکنه.
پس هوش مصنوعی جای برنامهنویسی رو نمیگیره؛ یکی از فناوریهاییه که میتونیم با کمک برنامهنویسی در یک نرمافزار به کار ببریم.
حالا که رابطه این دو روشن شد، سؤال کاربردیتری پیش میاد:
وقتی میخوایم برای کسبوکارمون یک سیستم بسازیم، از کجا بفهمیم به هوش مصنوعی نیاز داریم یا یک برنامه معمولی کارمون رو راه میاندازه؟
برای کسبوکار، چه زمانی برنامهنویسی و چه زمانی هوش مصنوعی مناسبتر است؟
فرض کن مدیر یک فروشگاه اینترنتی هستی و میخوای بخشی از کارها رو خودکار کنی. از محاسبه هزینه ارسال گرفته تا پاسخگویی به مشتریها و پیشبینی فروش ماه آینده.
آیا برای همه این کارها به هوش مصنوعی نیاز داری؟
نه! اتفاقاً بعضی کارها رو بهتره با چند قانون ساده انجام بدیم. بعضی کارها هم هستن که هوش مصنوعی میتونه کمک بیشتری بهمون بکنه.
بیا ببینیم چطور باید انتخاب کنیم.
چه زمانی یک نرمافزار معمولی کافی است؟
فرض کن فروشگاهت برای سفارشهای بالای دو میلیون تومان ارسال رایگان داره.
اینجا قانون کاملاً مشخصه. برنامه فقط باید مبلغ سفارش رو بررسی کنه و هزینه ارسال رو حساب کنه.
آیا لازمه یک مدل هوش مصنوعی آموزش بدیم تا تشخیص بده مشتری باید هزینه ارسال پرداخت کنه یا نه؟
معلومه که نه. حتی ممکنه استفاده از هوش مصنوعی برای چنین کاری دردسر بیشتری ایجاد کنه.
وقتی قانونها روشن هستن و نتیجه باید دقیق و قابلبررسی باشه، معمولاً برنامهنویسی قانونمحور انتخاب مناسبتریه.
محاسبه مبلغ فاکتور، اعمال تخفیف مشخص و کنترل دسترسی کاربران هم میتونن با همین روش انجام بشن.
چه زمانی هوش مصنوعی کاربرد بیشتری دارد؟
حالا فرض کن میخوای بدونی ماه آینده کدوم محصولات بیشتر فروش میرن.
اینجا دیگه یک قانون ساده مثل «اگر این شد، اون کار رو بکن» لزوماً کافی نیست.
ممکنه فروش به قیمت محصول، فصل، تخفیفها و رفتار مشتریها بستگی داشته باشه. تازه رابطه این عوامل هم همیشه ثابت نیست.
اگر اطلاعات مناسبی از فروشهای گذشته داشته باشیم، میتونیم از یک مدل یادگیری ماشین برای بررسی این رابطهها و پیشبینی تقاضا کمک بگیریم.
اما دقت کن؛
- هوش مصنوعی آینده رو نمیدونه.
- فقط براساس اطلاعات و الگوهایی که یاد گرفته، نتیجهای رو پیشبینی میکنه.
پس وقتی مسئله به تشخیص الگوهای پیچیده یا پیشبینی شرایط نامشخص مربوط میشه، استفاده از هوش مصنوعی میتونه مفید باشه؛ به شرطی که داده مناسب داشته باشیم و خطای احتمالی رو هم در نظر بگیریم.
چه زمانی باید هر دو روش را ترکیب کنیم؟
حالا بیا به همون سیستم پشتیبانی مشتریها برگردیم که در بخشهای قبلی ساختیم.
فرض کن مدل هوش مصنوعی پیام مشتری رو بررسی میکنه و تشخیص میده که احتمالاً یک شکایت مربوط به تأخیر در ارسال سفارشه.
خب، بعدش چی؟
آیا خود مدل باید تصمیم بگیره شکایت به کدوم واحد بره، چه زمانی پیگیری بشه و چه کسی مسئول پاسخگویی باشه؟
نه لزوماً. میتونیم این بخشها رو با قوانین مشخص کنترل کنیم.
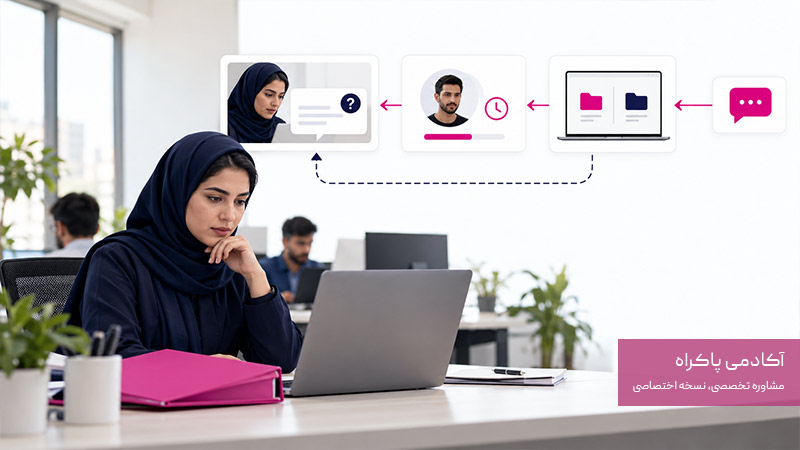
مثلاً سیستم اینطور کار کنه:
- مدل هوش مصنوعی موضوع پیام رو تشخیص میده.
- نرمافزار براساس موضوع تشخیصدادهشده، پیام رو به واحد مربوط میفرسته.
- اگر تا زمان مشخصی پاسخی ثبت نشد، برنامه پیام یادآوری ارسال میکنه.
- اگر مدل از تشخیص موضوع مطمئن نبود، پیام برای بررسی انسانی فرستاده میشه.
در این مثال فرضی، هوش مصنوعی به تشخیص موضوع کمک میکنه و برنامهنویسی قانونمحور، مراحل بعدی کار رو مدیریت میکنه.
پس قرار نیست همیشه یکی رو انتخاب کنیم و دیگری رو کنار بذاریم.
قبل از انتخاب هوش مصنوعی، این پنج سؤال را بپرس
حالا اگر خودت بخوای برای کسبوکارت تصمیم بگیری، از کجا شروع کنی؟
قبل از انتخاب ابزار، به این پنج سؤال جواب بده:
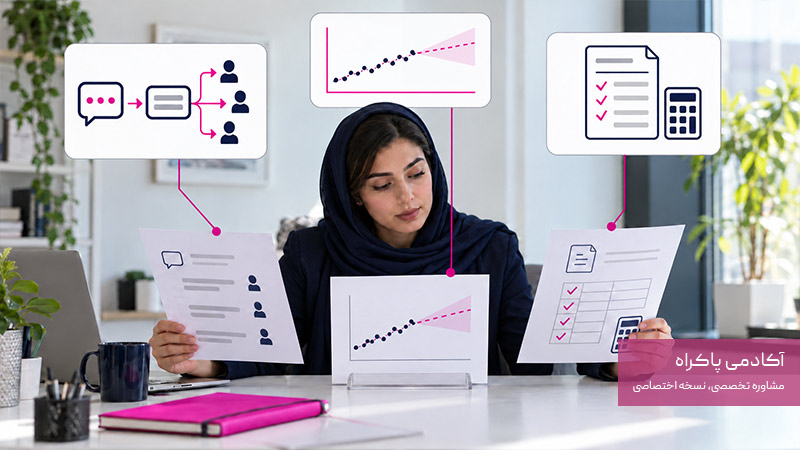
۱. قانون مسئله روشنه؟
- اگر میتونی کار رو با چند شرط مشخص انجام بدی، شاید اصلاً به مدل هوش مصنوعی نیاز نداشته باشی.
۲. خطا قابلقبوله؟
- اگر نتیجه اشتباه میتونه آسیب جدی ایجاد کنه، باید کنترلهای دقیقتری داشته باشی و ممکنه بعضی تصمیمها رو نباید به مدل بسپری.
۳. داده کافی و تمیز داریم؟
- اگر میخوای مدل اختصاصی آموزش بدی، باید اطلاعات مناسب و قابلاعتماد داشته باشی.
۴. تصمیم باید قابلتوضیح باشه؟
- اگر لازمه دقیقاً بدونی چرا سیستم یک تصمیم گرفته، باید این موضوع رو موقع انتخاب روش در نظر بگیری.
۵. هزینه پایش و آموزش دوباره رو داریم؟
- ساخت مدل پایان کار نیست.
- باید عملکردش رو بررسی کنی و اگر شرایط تغییر کرد، برای اصلاح اون آماده باشی.
من در سیستمسازی کسبوکار همیشه روی یک اصل تأکید دارم: «اول فرایند؛ بعد ابزار.»
اگر هنوز نمیدونیم یک کار باید چطور انجام بشه و چه نتیجهای ازش میخوایم، اضافهکردن هوش مصنوعی لزوماً مشکل رو حل نمیکنه.
اول باید مسئله رو بشناسیم؛ بعد ببینیم کدوم روش برای حلش مناسبتره.
حالا ممکنه بگی: «من که برنامهنویس نیستم؛ برای استفاده از این قابلیتها باید حتماً کدنویسی یاد بگیرم؟»
نه همیشه. این موضوع به کاری بستگی داره که میخوای با هوش مصنوعی انجام بدی.
آیا برای استفاده از هوش مصنوعی باید برنامهنویسی بلد باشیم؟
تا اینجا چند بار گفتیم هوش مصنوعی با برنامهنویسی ساخته میشه. حالا شاید فکر کنی برای استفاده از اون هم باید کدنویسی بلد باشی.
اما بیا یک تفاوت مهم رو روشن کنیم: استفاده از هوش مصنوعی با ساختن هوش مصنوعی یکی نیست.
فرض کن میخوای از ChatGPT کمک بگیری تا متن یک ایمیل رو بهتر بنویسی یا گزارش فروش رو خلاصه کنی. برای این کار لازم نیست برنامهنویسی بلد باشی. فقط باید بتونی درخواستت رو درست توضیح بدی و نتیجه رو بررسی کنی.
حالا یک قدم جلوتر بریم.
فرض کن میخوای سیستمی بسازی که پیامهای مشتریها رو دریافت کنه، موضوع اونها رو با هوش مصنوعی تشخیص بده و برای پیگیری به بخش مربوط بفرسته.
برای چنین کاری، بعضی ابزارهای بدون کد (No-Code) وجود دارن که میتونی با اتصال بخشهای آماده به هم، یک فرایند بسازی.
اما اینجا هم باید بدونی هر بخش چه کاری انجام میده و اگر نتیجه اشتباه بود، چطور مشکل رو پیدا کنی. ابزار بدون کد به معنی بینیازی از شناخت فرایند نیست.
حالا اگر بخوای خودت یک مدل یادگیری ماشین طراحی و آموزش بدی، ماجرا فرق میکنه. معمولاً باید برنامهنویسی، کار با دادهها و مفاهیم پایه ریاضی و آمار رو یاد بگیری.
پس اگر بین یادگیری هوش مصنوعی و برنامهنویسی مردد هستی، اول از خودت بپرس: میخوام از ابزارهای هوش مصنوعی استفاده کنم یا میخوام خودم اونها رو بسازم؟
جواب همین سؤال کمک میکنه مسیر یادگیری مناسبتری انتخاب کنی.
اما یک نگرانی دیگه هم وجود داره: اگر ابزارهای هوش مصنوعی میتونن کد بنویسن، آیا ممکنه دیگه به برنامهنویسها نیازی نداشته باشیم؟
آیا هوش مصنوعی جای برنامهنویسان را میگیرد؟
حالا که ابزارهای هوش مصنوعی میتونن کد بنویسن، شاید این سؤال برات پیش بیاد:
«پس چرا هنوز به برنامهنویس نیاز داریم؟»
ببین، فرض کن به یک ابزار هوش مصنوعی میگی:
«برای فروشگاهم یک سیستم ثبت سفارش بساز.»
ممکنه ابزار بخش زیادی از کدهای موردنیاز رو بنویسه. حتی میتونه در پیدا کردن خطاها و اصلاح کد هم کمک کنه.
- اما از کجا میفهمه قوانین فروشگاهت چیه؟
- اگر دو مشتری همزمان آخرین موجودی یک محصول رو سفارش بدن، سیستم باید چه تصمیمی بگیره؟
- چطور مطمئن بشیم اطلاعات مشتریها امن میمونه؟
اینجا فقط نوشتن کد مهم نیست. باید مسئله رو درست بشناسیم، رفتار سیستم رو طراحی کنیم و نتیجه رو در شرایط مختلف آزمایش کنیم.
تازه کدی که هوش مصنوعی تولید میکنه هم ممکنه اشتباه یا ناامن باشه.
پس هوش مصنوعی میتونه بخشی از کار برنامهنویس رو سریعتر کنه، اما تولید کد با ساختن یک نرمافزار قابلاعتماد یکی نیست.
اینکه در آینده چه کارهایی خودکار میشن و نقش برنامهنویسان چقدر تغییر میکنه، به پیشرفت فناوری و نیاز کسبوکارها بستگی داره. نمیشه با قطعیت گفت این شغل از بین میره.
برای بررسی گستردهتر این موضوع میتونی مقاله «آیا هوش مصنوعی جایگزین مشاغل انسانی میشود؟» رو بخونی.
جمعبندی: تفاوت هوش مصنوعی و برنامهنویسی چیست؟
حالا بیا برگردیم به سؤالی که اول مقاله پرسیدیم: وقتی هوش مصنوعی هم با برنامهنویسی ساخته میشه، پس چه فرقی با یک برنامه معمولی داره؟
دیدیم که در برنامهنویسی قانونمحور، خودمون مشخص میکنیم کامپیوتر در هر شرایطی چه کاری انجام بده. اما در یادگیری ماشین، روش آموزش رو مینویسیم تا مدل با بررسی دادهها و اصلاح خطاها، رابطههای لازم رو یاد بگیره.
پس تفاوت اصلی در این نیست که یکی کد داره و دیگری نداره؛ تفاوت در اینه که روش رسیدن به نتیجه چطور مشخص میشه.
البته هیچکدوم همیشه بهتر نیستن. گاهی چند قانون ساده مسئله رو حل میکنن و گاهی به مدلی نیاز داریم که بتونه الگوهای پیچیدهتری رو تشخیص بده.
برای همین، قبل از انتخاب هر فناوری، بهتره ببینیم دقیقاً چه مشکلی داریم و سادهترین راه قابلاعتماد برای حل اون چیه.
روی دکمه «مشاوره آنلاین» کلیک کنید تا مهندس ایمان پاکراه و تیم آکادمی پاکراه بهصورت آنلاین و کاملاً رایگان راهنماییتان کنند.
مشاوره آنلاین