



هوش مصنوعی با دریافت و پردازش اطلاعات، استفاده از الگوهای آموختهشده یا قوانین مشخص، میتونه کارهایی مثل تشخیص تصاویر، پیشبینی اتفاقات و پاسخدادن به سؤالها رو انجام بده.
بسیاری از سیستمهای هوش مصنوعی امروزی با استفاده از دادهها آموزش میبینن؛ یعنی تنظیماتشون طوری تغییر میکنه که بتونن از اطلاعات گذشته برای رسیدن به نتیجه در موقعیتهای جدید استفاده کنن.
اما این یادگیری دقیقاً چطور اتفاق میافته؟
فرض کن مدیر یک شرکت تعمیراتی هستی و میخوای بدونی فردا چند درخواست تعمیر کولر دریافت میکنی تا بتونی برای تعداد متخصصان موردنیاز برنامهریزی کنی.
اطلاعات روزهای گذشته رو داری؛ مثلاً میدونی در هر روز دمای هوا چند درجه بوده و چند درخواست تعمیر ثبت شده.
حالا میخوای یک مدل هوش مصنوعی با بررسی این اطلاعات، رابطه بین دمای هوا و تعداد درخواستها رو یاد بگیره و برای فردا پیشبینی کنه.
اما سؤال اینجاست:
مدل از کجا میفهمه چه رابطهای بین این اطلاعات وجود داره؟
اگر پیشبینی اشتباه باشه، چطور خطاش رو تشخیص میده و خودش رو اصلاح میکنه؟
در این مقاله از آکادمی پاکراه، با همین مثال قدمبهقدم جلو میریم؛ از آمادهکردن اطلاعات و آموزش مدل تا محاسبه خطا، اصلاح تنظیمات و بررسی نتیجه. در ادامه هم میبینیم شبکههای عصبی و ابزارهایی مثل ChatGPT چطور از این مفاهیم برای انجام کارهای پیچیدهتر استفاده میکنن.
- هوش مصنوعی از دریافت اطلاعات تا تولید جواب چه مراحلی را طی میکند؟
- هوش مصنوعی اطلاعات را چگونه دریافت و آماده میکند؟
- هوش مصنوعی چگونه از دادهها یاد میگیرد؟
- آیا همه مدلهای هوش مصنوعی به یک روش نتیجه میرسند؟
- از کجا بفهمیم هوش مصنوعی واقعاً یاد گرفته است؟
- هوش مصنوعی بعد از آموزش چگونه پاسخ میدهد؟
- چرا هوش مصنوعی گاهی اشتباه میکند؟
- شناخت نحوه کار هوش مصنوعی چه کاربردی در تصمیمگیری دارد؟
- جمعبندی
هوش مصنوعی از دریافت اطلاعات تا تولید جواب چه مراحلی را طی میکند؟
در مثال شرکت تعمیراتی، گفتیم که میخوایم هوش مصنوعی تعداد درخواستهای تعمیر کولر در روز آینده رو پیشبینی کنه.
اما کامپیوتر که خودش نمیدونه چه عواملی روی تعداد درخواستها تأثیر دارن. پس چطور میتونه به یک عدد برسه؟
ببین، برای ساخت بسیاری از سیستمهای هوش مصنوعی، مسیری رو طی میکنیم که از مشخصکردن مسئله شروع میشه و به استفاده از یک مدل آموزشدیده میرسه.
بیا مراحل این مسیر رو ببینیم. اما قبل از شروع، اگر هنوز با مفهوم کلی این فناوری آشنا نیستی، پیشنهاد میکنم اول مقاله “هوش مصنوعی چیست؟” رو بخونی؛ اینجا قراره یک قدم جلوتر بریم و نحوه کارش رو بررسی کنیم.
۱. مشخص میکنیم هوش مصنوعی چه کاری باید انجام دهد
اول باید بدونیم چه نتیجهای میخوایم.
در مثال ما، هدف اینه که سیستم بتونه با استفاده از اطلاعات موجود، تعداد تقریبی درخواستهای تعمیر کولر در روز آینده رو پیشبینی کنه.
پس خروجی موردنظر ما یک عدده؛ مثلاً ۱۲۰ درخواست.
۲. اطلاعات موردنیاز را جمعآوری میکنیم
حالا باید اطلاعاتی داشته باشیم که به پیشبینی کمک کنن.
مثلاً تعداد درخواستهای روزهای گذشته، دمای هوا، روزهای هفته و تعطیلات.
این اطلاعات رو داده (Data) میگیم.
البته هر اطلاعاتی به دردمون نمیخوره. باید دادههایی رو انتخاب کنیم که احتمالاً با مسئله ما ارتباط دارن.
۳. اطلاعات را برای آموزش آماده میکنیم
فرض کن تعداد درخواستهای یک روز اشتباه ثبت شده یا اطلاعات مربوط به دمای بعضی روزها وجود نداره.
اگر بدون بررسی از این دادهها استفاده کنیم، ممکنه مدل رابطههای اشتباهی یاد بگیره.
برای همین، قبل از آموزش باید اطلاعات ناقص، نادرست یا نامناسب رو بررسی کنیم.
۴. یک مدل انتخاب میکنیم و به آن آموزش میدهیم
حالا نوبت یادگیریه.
مدل (Model) بخشی از سیستمه که اطلاعات رو پردازش میکنه و براساس ساختار و تنظیماتش به نتیجه میرسه.
در بسیاری از روشهای یادگیری ماشین، مدل ابتدا با تنظیماتی شروع میکنه که هنوز برای مسئله ما مناسب نیستن.
بعد با استفاده از دادههای آموزشی، این تنظیمات تغییر میکنن تا مدل بتونه رابطههای مفید رو یاد بگیره.
مثلاً یاد بگیره که افزایش دما، در کنار عوامل دیگه، ممکنه با افزایش درخواستهای تعمیر کولر همراه باشه.
۵. بررسی میکنیم مدل چقدر درست پیشبینی میکند
فرض کن مدل رو آموزش دادیم و حالا تعداد درخواستهای چند روز گذشته رو پیشبینی میکنه.
آیا همین کافیه؟
نه. باید ببینیم روی اطلاعاتی که در آموزش استفاده نکردیم هم نتیجه مناسبی میده یا نه.
برای این کار، پیشبینیهای مدل رو با اتفاقات واقعی مقایسه میکنیم و اندازه اشتباهاتش رو میسنجیم.
اگر نتیجه قابلقبول نباشه، ممکنه لازم بشه دادهها، مدل یا روش آموزش رو اصلاح کنیم.
۶. از مدل آموزشدیده استفاده میکنیم
حالا فرض کن مدل آزمایش شده و عملکرد مناسبی داشته.
دمای پیشبینیشده فردا، روز هفته و سایر اطلاعات موردنیاز رو بهش میدیم.
مدل با استفاده از تنظیماتی که هنگام آموزش یاد گرفته، تعداد احتمالی درخواستهای فردا رو محاسبه میکنه.
مثلاً ممکنه پیشبینی کنه که فردا حدود ۱۲۰ درخواست ثبت میشه.
مدیر شرکت میتونه از این عدد برای برنامهریزی کمک بگیره؛ البته باید خطای احتمالی پیشبینی رو هم در نظر داشته باشه.
۷. عملکرد مدل را بعد از استفاده هم بررسی میکنیم
کار ما با اولین پیشبینی تموم نمیشه.
ممکنه شرایط بازار، رفتار مشتریها یا الگوی تقاضا تغییر کنه و مدل بهمرور دقت قبلی رو نداشته باشه.
پس باید پیشبینیها رو با نتایج واقعی مقایسه کنیم و اگر لازم بود، مدل رو با اطلاعات جدید بهروزرسانی کنیم.
آیا تمام سیستمهای هوش مصنوعی به همین روش کار میکنند؟
نه. این مراحلی که توضیح دادیم، مسیر رایج ساخت و استفاده از سیستمهای مبتنی بر یادگیری ماشین (Machine Learning) هست.
بعضی سیستمهای هوش مصنوعی براساس قانونهایی کار میکنن که انسان از قبل مشخص کرده و برای انجام کارشون نیازی به یادگیری از دادهها ندارن.
حتی در یادگیری ماشین هم همه مدلها به یک روش آموزش نمیبینن.
پس مسیر کلی مثال ما اینه:
مشخصکردن مسئله ← جمعآوری و آمادهسازی داده ← انتخاب و آموزش مدل ← ارزیابی ← استفاده از مدل ← بررسی عملکرد در دنیای واقعی
این مسیر به ما کمک میکنه جای هر مرحله رو بشناسیم. اما هنوز نمیدونیم مدل دقیقاً چطور از دادهها یاد میگیره.
برای فهمیدن این موضوع، اول باید ببینیم دادهها، الگوریتم و مدل چه تفاوتی با هم دارن و اطلاعات چطور برای محاسبات آماده میشن.
هوش مصنوعی اطلاعات را چگونه دریافت و آماده میکند؟
در بخش قبل دیدیم که برای آموزش یک مدل هوش مصنوعی، به داده نیاز داریم. اما آیا کافیه اطلاعات رو جمع کنیم و به کامپیوتر بدیم تا خودش همهچیز رو یاد بگیره؟
نه دقیقاً. اول باید ببینیم چه اطلاعاتی به دردمون میخورن، از کجا به دست میان و چطور باید برای آموزش آماده بشن.
۱. دادههای آموزشی هوش مصنوعی از کجا میآیند؟
به اطلاعاتی که برای آموزش یک مدل استفاده میکنیم، داده آموزشی (Training Data) میگیم.
این اطلاعات میتونن از منابع مختلفی به دست بیان؛ مثل گزارشهای فروش، تصاویر، فایلهای صوتی یا سوابق ثبتشده در یک نرمافزار.
اما نوع داده به کاری بستگی داره که میخوایم مدل انجام بده.
به مثال شرکت تعمیراتی برگردیم.
ما میخوایم تعداد درخواستهای تعمیر کولر رو پیشبینی کنیم. بنابراین میتونیم اطلاعات زیر رو جمعآوری کنیم:
- دمای هوا در روزهای گذشته
- تعداد درخواستهای ثبتشده در هر روز
- روزهای هفته و تعطیلات
- منطقه ثبت درخواستها
مثلاً ممکنه متوجه بشیم که در بعضی روزهای گرم، تعداد درخواستها بیشتر بوده.
اما آیا صرفاً با دیدن چند روز گرم میتونیم نتیجه بگیریم که هرچقدر دما بالاتر بره، حتماً درخواست تعمیر هم بیشتر میشه؟
نه. عوامل دیگهای هم ممکنه روی تقاضا اثر بذارن. به همین دلیل، مدل باید با اطلاعات کافی و مرتبط آموزش ببینه.
۲. چرا دادهها باید قبل از آموزش بررسی شوند؟
فرض کن در اطلاعات شرکت ثبت شده که در یک روز با دمای ۳۵ درجه، تعداد ۸۰۰ درخواست تعمیر کولر دریافت شده.
اما وقتی گزارش رو بررسی میکنی، متوجه میشی تعداد واقعی ۸۰ درخواست بوده و یک صفر اضافه ثبت شده.
حالا اگر این اشتباه رو اصلاح نکنیم، چه اتفاقی میافته؟
مدل ممکنه براساس این اطلاعات نادرست، رابطه اشتباهی بین دمای هوا و تعداد درخواستها یاد بگیره.
برای همین، قبل از آموزش مرحلهای به نام آمادهسازی داده (Data Preparation) داریم.
در این مرحله معمولاً اطلاعات ناقص، اشتباه یا تکراری رو بررسی میکنیم و مطمئن میشیم دادهها در قالب مناسبی قرار دارن.
البته آمادهسازی به معنی حذف خودکار هر عدد عجیب نیست. شاید واقعاً در یک روز تعداد درخواستها به شکل غیرعادی زیاد شده باشه. اول باید دلیلش رو بررسی کنیم.
۳. هوش مصنوعی چگونه متن، تصویر و اطلاعات را پردازش میکند؟
تا اینجا درباره دمای هوا و تعداد درخواستها صحبت کردیم که هر دو عدد هستن.
اما اگر بخوایم به هوش مصنوعی یک متن، عکس یا فایل صوتی بدیم، چی؟
کامپیوتر برای انجام محاسبات با دادههای عددی کار میکنه. بنابراین اطلاعات باید به شکلی نمایش داده بشن که مدل بتونه اونها رو پردازش کنه.
مثلاً:
- متن: به بخشهای کوچکتر تقسیم میشه و به نمایشهای عددی تبدیل میشه تا مدل بتونه ارتباط بخشهای مختلفش رو بررسی کنه.
- تصویر: از پیکسلهایی تشکیل شده که اطلاعات رنگ و روشنایی اونها بهصورت عدد ثبت میشه.
- صدا: به شکل دادههای دیجیتال ذخیره و برای پردازش آماده میشه.
حالا فرض کن میخوایم مدلی بسازیم که پیامهای مشتریان رو بررسی کنه و شکایتها رو تشخیص بده.
یکی از مشتریها نوشته:
«سه روزه منتظرم، چرا هنوز تعمیرکار نیومده؟»
ما با خوندن جمله متوجه نارضایتی مشتری میشیم.
اما مدل باید متن رو به شکل عددی پردازش کنه و از الگوهایی که یاد گرفته، برای تشخیص موضوع پیام استفاده کنه.
البته تبدیل متن به عدد، بهتنهایی باعث فهمیدن شکایت نمیشه. مدل باید قبلاً برای تشخیص چنین الگوهایی آموزش دیده باشه.
۴. مدل از کجا میفهمد جواب درست چیست؟
اینجا یک سؤال مهم پیش میاد.
فرض کن هزار پیام مشتری داریم و میخوایم مدلی آموزش بدیم که شکایتها رو تشخیص بده.
مدل از کجا میفهمه کدوم پیام شکایته و کدوم فقط یک سؤال معمولیه؟
یکی از روشها اینه که نمونهها رو از قبل بررسی کنیم و پاسخ درستشون رو مشخص کنیم.
مثلاً:
| پیام مشتری | برچسب |
|---|---|
| چرا تعمیرکار هنوز مراجعه نکرده؟ | شکایت |
| ساعت کاری شما چنده؟ | سؤال معمولی |
| از خدماتتون راضی نبودم. | شکایت |
به مشخصکردن پاسخ یا دسته درست هر نمونه، برچسبگذاری داده (Data Labeling) میگن.
مدل میتونه با استفاده از این نمونهها آموزش ببینه تا پیامهای جدید رو هم دستهبندی کنه.
اما آیا تمام هوش مصنوعیها باید جواب درست هر نمونه رو از قبل داشته باشن؟
نه. بعضی روشهای یادگیری از دادههای بدون برچسب استفاده میکنن و بعضی هم به شکل متفاوتی آموزش میبینن. جلوتر با این روشها آشنا میشیم.
آیا هرچقدر داده بیشتری داشته باشیم، مدل بهتر یاد میگیره؟
لزوماً نه.
فرض کن برای پیشبینی درخواست تعمیر کولر، اطلاعات هزاران روز رو داشته باشیم، اما بیشتر این اطلاعات اشتباه یا نامرتبط باشن.
چنین دادههایی ممکنه حتی باعث بشن مدل نتیجه بدتری بگیره.
مهم اینه که اطلاعات کافی، مرتبط و باکیفیتی داشته باشیم که تا حد امکان شرایط واقعی مسئله رو نشون بدن.
حالا دادهها رو جمعآوری و آماده کردیم. اما هنوز مدل چیزی از اونها یاد نگرفته.
سؤال بعدی اینه: وقتی این اطلاعات رو به مدل میدیم، دقیقاً چه اتفاقی میافته که میتونه رابطه بین دادهها رو یاد بگیره؟
برای جواب، باید با الگوریتم، مدل و پارامتر آشنا بشیم و بعد با یک مثال عددی ببینیم یادگیری چطور اتفاق میافته.
هوش مصنوعی چگونه از دادهها یاد میگیرد؟
تا اینجا اطلاعات رو جمعآوری و آماده کردیم. اما هنوز نمیدونیم وقتی این دادهها وارد مدل میشن، دقیقاً چه اتفاقی میافته که هوش مصنوعی میتونه چیزی یاد بگیره.
برای فهمیدن این موضوع، اول باید سه مفهوم رو بشناسیم: الگوریتم، مدل و پارامتر.
۱. الگوریتم، مدل و پارامتر چه تفاوتی دارند؟
به مثال شرکت تعمیراتی برگردیم.
فرض کن میخوایم با استفاده از دمای هوا، تعداد درخواستهای تعمیر کولر رو پیشبینی کنیم.
برای این کار، به مدلی نیاز داریم که بتونه دمای هوا رو دریافت کنه و تعداد احتمالی درخواستها رو محاسبه کنه.
اما مدل از کجا میفهمه چه رابطهای بین دما و تعداد درخواستها وجود داره؟
اینجاست که این سه مفهوم به کار میان:
- الگوریتم (Algorithm): روشی که مشخص میکنه محاسبات چطور انجام بشن. مثلاً الگوریتم آموزش مشخص میکنه تنظیمات مدل چطور اصلاح بشن.
- مدل (Model): ساختاری محاسباتیه که اطلاعات رو دریافت میکنه و براساس تنظیماتش، یک نتیجه تولید میکنه.
- پارامتر (Parameter): عددی درون مدله که روی نتیجه محاسبات اثر میذاره و در بسیاری از روشها هنگام آموزش تغییر میکنه.
شاید هنوز تفاوتشون روشن نباشه. بیا با یک محاسبه ساده ببینیم هرکدوم چه کاری انجام میدن.
۲. مدل چگونه اولین پیشبینی را انجام میدهد؟
فرض کن برای شروع، یک مدل بسیار ساده داریم که تعداد درخواستهای تعمیر کولر رو با ضربکردن دمای هوا در یک عدد محاسبه میکنه.
فرمول فرضی مدل ما اینه:
تعداد درخواستهای پیشبینیشده = دمای هوا × پارامتر
دقت کن که این فقط یک مدل آموزشی سادهست. در واقعیت، تعداد درخواستهای تعمیر به عوامل بیشتری بستگی داره و رابطه اونها لزوماً به این شکل نیست.
حالا فرض کنیم:
- دمای هوا: ۳۰ درجه
- پارامتر اولیه مدل: ۲
مدل محاسبه میکنه:
۳۰ × ۲ = ۶۰ درخواست
پس مدل ما پیشبینی کرده که در یک روز با دمای ۳۰ درجه، تعداد ۶۰ درخواست تعمیر ثبت میشه.
اما آیا این عدد درسته؟
هنوز نمیدونیم. برای بررسی، باید پیشبینی مدل رو با اطلاعات واقعی مقایسه کنیم.
۳. مدل از کجا میفهمد اشتباه کرده است؟
یادت هست مدل ما با دمای ۳۰ درجه، تعداد ۶۰ درخواست تعمیر رو پیشبینی کرد؟
حالا فرض کن این اطلاعات مربوط به یکی از روزهای گذشتهست و ما میدونیم در اون روز، واقعاً ۹۰ درخواست ثبت شده.
پس مدل چقدر اشتباه کرده؟
۹۰ − ۶۰ = ۳۰
یعنی مدل ۳۰ درخواست کمتر از مقدار واقعی پیشبینی کرده.
تا اینجا محاسبه خیلی سادهست. اما یک سؤال پیش میاد:
اگر مدل رو با اطلاعات صدها روز آموزش بدیم، چطور بفهمیم در مجموع چقدر اشتباه کرده؟
فرض کن مدل برای دو روز مختلف، این پیشبینیها رو انجام داده:
| روز | اختلاف پیشبینی با واقعیت |
|---|---|
| روز اول | ۳۰ درخواست کمتر |
| روز دوم | ۳۰ درخواست بیشتر |
اگر اختلافها رو با علامت جمع کنیم، نتیجه صفر میشه؛ چون ۳۰− و ۳۰+ همدیگه رو خنثی میکنن.
اما آیا مدل هیچ اشتباهی نکرده؟
معلومه که نه! هر دو روز، ۳۰ درخواست اشتباه پیشبینی کرده.
پس برای اندازهگیری خطا باید روشی داشته باشیم که اشتباهات مثبت و منفی همدیگه رو خنثی نکنن.
یکی از این روشها خطای مربعی (Squared Error) هست.
در این روش، اختلاف پیشبینی با مقدار واقعی رو در خودش ضرب میکنیم.
مثلاً برای روز اول:
۳۰ × ۳۰ = ۹۰۰
و برای روز دوم:
(۳۰−) × (۳۰−) = ۹۰۰
حالا در هر دو حالت، مقدار خطا مثبت شده و میتونیم از اونها برای محاسبه خطای کلی مدل استفاده کنیم.
اما چرا از توان دو استفاده میکنیم؟ نمیشه فقط علامت منفی رو حذف کنیم؟
چرا، میشه! روشی به نام قدرمطلق خطا هم وجود داره که در اون فقط اندازه اختلاف رو حساب میکنیم.
اما خطای مربعی یک ویژگی دیگه هم داره: به اشتباهات بزرگتر، وزن بیشتری میده.
مثلاً:
- اختلاف ۲ درخواست ← خطای مربعی ۴
- اختلاف ۱۰ درخواست ← خطای مربعی ۱۰۰
یعنی خطایی که ۵ برابر بزرگتره، در محاسبه مربعی ۲۵ برابر اثر داره.
این ویژگی باعث میشه مدل هنگام آموزش برای کاهش خطاهای بزرگتر فشار بیشتری دریافت کنه.
وقتی میگیم خطای مربعی مدل ۹۰۰ شده، منظورمون این نیست که ۹۰۰ درخواست رو اشتباه پیشبینی کرده!
مدل همچنان ۳۰ درخواست اختلاف داشته. عدد ۹۰۰ فقط امتیازی برای اندازهگیری خطاست که با فرمول انتخابی ما محاسبه شده.
به فرمولی که برای اندازهگیری اشتباه مدل استفاده میکنیم، تابع خطا یا تابع زیان (Loss Function) میگن.
حالا میدونیم مدل چقدر اشتباه کرده و میتونیم خطای اون رو اندازه بگیریم.
اما سؤال مهمتر اینه: چطور باید عددهای داخل مدل رو تغییر بدیم تا این خطا کمتر بشه؟
۴. پارامترهای مدل چگونه اصلاح میشوند؟
تا اینجا فهمیدیم مدل ما ۶۰ درخواست تعمیر پیشبینی کرده، درحالیکه تعداد واقعی ۹۰ درخواست بوده.
حالا سؤال اینه:
هوش مصنوعی چطور متوجه میشه چه عددی رو باید تغییر بده تا پیشبینی دقیقتر بشه؟
یادت هست مدل ما یک فرمول ساده داشت؟
تعداد درخواستهای پیشبینیشده = دمای هوا × پارامتر
دمای هوا ۳۰ درجه بود و پارامتر رو ۲ در نظر گرفتیم:
۳۰ × ۲ = ۶۰ درخواست
حالا اگر پارامتر رو از ۲ به ۳ تغییر بدیم، چی میشه؟
۳۰ × ۳ = ۹۰ درخواست
دیدی چه اتفاقی افتاد؟ با تغییر یک عدد، پیشبینی مدل به مقدار واقعی رسید.
اما یک مشکل وجود داره.
ما جواب درست رو از قبل میدونستیم و خودمون پارامتر رو تغییر دادیم. در مدلهای واقعی که ممکنه میلیونها پارامتر داشته باشن، چطور میشه فهمید هر عدد باید چقدر تغییر کنه؟
اینجاست که یکی از روشهای مهم آموزش، یعنی گرادیان کاهشی (Gradient Descent) به کمکمون میاد.
گرادیان کاهشی چیست؟
فرض کن بالای یک تپه ایستادی و میخوای به پایینترین نقطه برسی، اما مه غلیظه و نمیتونی مسیر رو ببینی.
چه کار میکنی؟
میتونی شیب زمین رو بررسی کنی، یک قدم به سمت پایین برداری و دوباره شیب رو بسنجی.
با تکرار این کار، ممکنه به نقطه پایینتری برسی.
گرادیان کاهشی هم از همین ایده استفاده میکنه.
برنامه آموزشی با استفاده از محاسبات ریاضی بررسی میکنه که تغییر پارامترها در چه جهتی باعث کمترشدن خطا میشه.
برای اندازهگیری این تغییر از مفهومی به نام مشتق (Derivative) استفاده میکنیم.
مشتق در مثال ساده ما کمک میکنه بفهمیم اگر پارامتر کمی افزایش پیدا کنه، خطا بیشتر میشه یا کمتر.
اما هنوز یک سؤال داریم: چقدر باید پارامتر رو تغییر بدیم؟
نرخ یادگیری چه کاری انجام میدهد؟
فرض کن روی همون تپه هستی و میخوای به سمت پایین حرکت کنی.
اگر قدمهای خیلی بزرگی برداری، ممکنه از نقطه مناسب عبور کنی. اگر قدمهات بیشازحد کوچک باشن، رسیدن به نتیجه طول میکشه.
در آموزش مدل هم باید اندازه تغییر پارامترها رو کنترل کنیم.
به عددی که اندازه این قدمها رو تعیین میکنه، نرخ یادگیری (Learning Rate) میگیم.
حالا بیایم یک مرحله از آموزش مدل تعمیر کولر رو محاسبه کنیم.
مثال عددی: مدل چطور پارامترش رو اصلاح میکنه؟
تا اینجا داریم:
- دما: ۳۰ درجه
- تعداد واقعی درخواستها: ۹۰
- پارامتر فعلی: ۲
- پیشبینی مدل: ۶۰
- خطای مربعی: ۹۰۰
برنامه آموزشی با محاسبه مشتق تابع خطا به عدد ۱۸۰۰− میرسه.
فعلاً لازم نیست نحوه مشتقگیری رو بلد باشی. فقط بدون که منفیبودن این عدد در مثال ما نشون میده برای کاهش خطا باید پارامتر رو افزایش بدیم.
فرض کنیم نرخ یادگیری رو ۰٫۰۰۰۱ انتخاب کردیم.
حالا برنامه از این فرمول استفاده میکنه:
پارامتر جدید = پارامتر قبلی − (نرخ یادگیری × مشتق خطا)
اعداد رو جایگذاری میکنیم:
۲ − (۰٫۰۰۰۱ × ۱۸۰۰−) = ۲٫۱۸
پس پارامتر از ۲ به ۲٫۱۸ تغییر کرد.
حالا مدل دوباره پیشبینی میکنه:
۳۰ × ۲٫۱۸ = ۶۵٫۴
نتیجه از ۶۰ به ۶۵٫۴ درخواست رسید؛ یعنی به مقدار واقعی ۹۰ نزدیکتر شد.
اگر خطای مربعی جدید رو حساب کنیم:
(۶۵٫۴ − ۹۰)² = ۶۰۵٫۱۶
پس خطای مربعی از ۹۰۰ به ۶۰۵٫۱۶ کاهش پیدا کرده.
حالا ببین دقیقاً چه اتفاقی افتاد:
مدل ابتدا پیشبینی کرد، برنامه آموزشی خطا رو محاسبه کرد، جهت مناسب تغییر پارامتر رو پیدا کرد و با توجه به نرخ یادگیری، پارامتر رو کمی اصلاح کرد.
این یعنی یک مرحله از آموزش مدل رو انجام دادیم.
اما آیا با همین یک مرحله، مدل یاد گرفته که تعداد درخواستهای تعمیر رو درست پیشبینی کنه؟
نه. ما فقط از یک نمونه استفاده کردیم. در آموزش واقعی، این محاسبات با نمونههای مختلف تکرار میشن تا تنظیمات مدل در مجموع بهتر بشن.
سه مفهوم رو با هم اشتباه نگیر:
- تابع خطا: مشخص میکنه پیشبینی مدل چقدر با نتیجه موردنظر فاصله داره.
- گرادیان: نشون میده تغییر پارامترها چه اثری بر خطا داره و به تعیین جهت اصلاح کمک میکنه.
- نرخ یادگیری: اندازه قدم تغییر پارامترها رو کنترل میکنه.
نکته مهم اینه که کاهش خطا در یک مرحله یا روی یک نمونه، تضمین نمیکنه مدل روی تمام اطلاعات نتیجه بهتری بگیره.
حالا که فهمیدیم یک پارامتر چطور اصلاح میشه، ببینیم وقتی مدل با هزاران نمونه روبهرو میشه، این فرایند یادگیری چطور ادامه پیدا میکنه.
۵. آیا هوش مصنوعی با یک بار اصلاح پارامتر یاد میگیرد؟
تا اینجا دیدیم که مدل ما با تغییر پارامتر از ۲ به ۲٫۱۸، تونست پیشبینی خودش رو از ۶۰ به ۶۵٫۴ درخواست برسونه و خطاش رو کمتر کنه.
اما یک سؤال مهم داریم: آیا اگر همینطور پارامتر رو تغییر بدیم تا به ۹۰ درخواست برسیم، مدل آموزش دیده؟
نه لزوماً!
چون ما تا اینجا فقط اطلاعات یک روز رو بررسی کردیم؛ روزی که دمای هوا ۳۰ درجه بوده و ۹۰ درخواست تعمیر ثبت شده.
حالا فرض کن روز دیگهای با همین دما، فقط ۷۵ درخواست ثبت شده باشه.
مدل باید کدوم عدد رو یاد بگیره؟ ۹۰ یا ۷۵؟
جواب اینه که مدل نباید فقط برای یک روز تنظیم بشه. باید اطلاعات روزهای مختلف رو بررسی کنه و رابطهای پیدا کنه که در مجموع پیشبینیهای مناسبی داشته باشه.
مدل چگونه با نمونههای بیشتر آموزش میبیند؟
فرض کن اطلاعات چند روز گذشته رو داریم:
| دمای هوا | درخواستهای واقعی |
|---|---|
| ۲۵ درجه | ۶۵ درخواست |
| ۳۰ درجه | ۹۰ درخواست |
| ۳۰ درجه | ۷۵ درخواست |
| ۳۵ درجه | ۱۱۰ درخواست |
حالا برنامه آموزشی این نمونهها رو در اختیار مدل قرار میده.
مدل با پارامتر فعلی خودش برای هر نمونه پیشبینی میکنه. بعد برنامه آموزشی اختلاف پیشبینیها با تعداد واقعی درخواستها رو اندازه میگیره.
این بار هدف این نیست که خطای فقط یک روز رو به صفر برسونیم.
هدف اینه که تنظیمات مدل طوری تغییر کنن که خطای کلی روی نمونههای آموزشی کمتر بشه.
برای همین، برنامه میتونه خطای نمونهها رو با هم ترکیب کنه؛ مثلاً میانگین خطای مربعی رو محاسبه کنه و از اون برای اصلاح پارامتر استفاده کنه.
این فرایند بارها تکرار میشه:
- ۱مدل با تنظیمات فعلی پیشبینی میکنه.
- برنامه آموزشی خطا رو اندازه میگیره.
- جهت و اندازه مناسب تغییر پارامترها محاسبه میشه.
- پارامترها اصلاح میشن.
- مدل دوباره با نمونههای آموزشی کار میکنه.
در بسیاری از روشهای آموزش، این مراحل با گروههای مختلفی از دادهها تکرار میشن تا مدل به تنظیمات مناسبتری برسه.
آیا هرچه بیشتر آموزش بدهیم، مدل بهتر میشود؟
نه همیشه.
فرض کن یک دانشآموز جواب تمام سؤالهای یک برگه امتحانی رو حفظ کرده.
اگر دوباره همون سؤالها رو بهش بدیم، احتمالاً نمره خوبی میگیره. اما اگر سؤالها کمی تغییر کنن، ممکنه نتونه جواب بده.
برای مدل هوش مصنوعی هم ممکنه چنین اتفاقی بیفته.
مدل میتونه روی اطلاعات آموزشی خطای کمی داشته باشه، اما وقتی اطلاعات جدید دریافت میکنه، عملکرد خوبی نداشته باشه.
پس کمشدن خطای آموزش، بهتنهایی ثابت نمیکنه که مدل واقعاً برای پیشبینی شرایط جدید آمادهست.
باید اون رو با اطلاعاتی آزمایش کنیم که هنگام آموزش ازشون استفاده نکرده.
جلوتر این موضوع رو با مفهوم «تعمیمپذیری» و «بیشبرازش» بررسی میکنیم.
یک نکته درباره مثال تعمیر کولر
مدل یکپارامتری ما فقط برای فهمیدن منطق یادگیری طراحی شده.
در یک مدل واقعی ممکنه دمای هوا، تعطیلات، منطقه، فصل و عوامل دیگه هم بررسی بشن. چنین مدلی معمولاً پارامترهای بیشتری داره و میتونه رابطههای پیچیدهتری رو یاد بگیره.
حالا فهمیدیم مدل چطور با نمونههای مختلف آموزش میبینه. اما آیا همه مدلهای هوش مصنوعی همین فرایند رو طی میکنن و برای یادگیری به جواب درست نیاز دارن؟
برای پاسخ باید با روشهای مختلف یادگیری آشنا بشیم.
۶. آیا تمام مدلهای هوش مصنوعی به یک روش یاد میگیرند؟
تا اینجا مدلی رو آموزش دادیم که تعداد درخواستهای تعمیر کولر رو پیشبینی میکرد.
ما تعداد واقعی درخواستهای روزهای گذشته رو میدونستیم. بنابراین هر بار که مدل پیشبینی میکرد، میتونستیم نتیجه رو با مقدار واقعی مقایسه کنیم و از اختلاف اونها برای آموزش استفاده کنیم.
اما یک سؤال پیش میاد: اگر جواب درست رو از قبل نداشته باشیم، هوش مصنوعی چطور یاد میگیره؟
ببین، همه مدلها به یک روش آموزش نمیبینن. چهار روش مهم یادگیری رو با مثال بررسی کنیم.
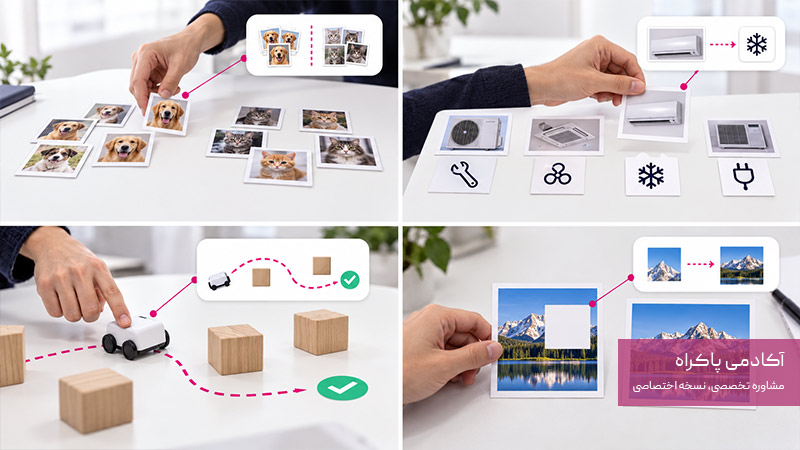
۱. یادگیری نظارتشده (Supervised Learning)
این همون روشی بود که در مثال تعمیر کولر استفاده کردیم.
اطلاعات رو به مدل میدیم و جواب درست هر نمونه رو هم مشخص میکنیم.
مثلاً:
- دمای هوا: ۳۰ درجه
- تعداد واقعی درخواستها: ۹۰
مدل پیشبینی خودش رو انجام میده و برنامه آموزشی از اختلاف اون با جواب واقعی برای اصلاح مدل استفاده میکنه.
پس در این روش، نمونه آموزشی همراه با جواب موردنظر در اختیار مدل قرار میگیره.
۲. یادگیری بدون نظارت (Unsupervised Learning)
حالا فرض کن مدیر یک فروشگاه اینترنتی هستی و اطلاعات خرید هزار مشتری رو داری.
میخوای بفهمی آیا بین این مشتریها گروههایی با رفتار خرید مشابه وجود داره یا نه.
اما از قبل مشخص نکردی که هر مشتری باید در کدوم گروه قرار بگیره.
در این حالت میتونیم از روشهای یادگیری بدون نظارت کمک بگیریم.
مثلاً یک الگوریتم خوشهبندی میتونه اطلاعات خرید رو بررسی کنه و مشتریانی رو که رفتار مشابهی دارن، در گروههای نزدیک به هم قرار بده.
ممکنه بعد از بررسی گروهها متوجه بشی بعضی مشتریها بیشتر محصولات اقتصادی میخرن و بعضی خریدهای گرانقیمتتری دارن.
تفاوتش با روش قبلی چیه؟
در یادگیری بدون نظارت، جواب یا گروه درست هر نمونه رو از قبل مشخص نکردیم. الگوریتم تلاش میکنه ساختارها یا الگوهای موجود در دادهها رو پیدا کنه.
۳. یادگیری خودنظارتی (Self-Supervised Learning)
حالا فرض کن میلیونها جمله در اختیار داریم و میخوایم یک مدل زبانی آموزش بدیم.
آیا باید یک نفر تمام این جملهها رو بخونه و برای هرکدوم جواب درست بنویسه؟
لزوماً نه.
در یادگیری خودنظارتی، میتونیم از خود اطلاعات برای ساختن تمرین آموزشی استفاده کنیم.
مثلاً این جمله رو در نظر بگیر:
«مشتری برای تعمیر یخچال درخواست ثبت کرده است.»
برنامه آموزشی میتونه بخشی از جمله رو در اختیار مدل قرار بده:
«مشتری برای تعمیر یخچال درخواست …»
و از مدل بخواد ادامه متن رو پیشبینی کنه.
چون ادامه واقعی جمله رو داریم، میتونیم پیشبینی مدل رو با اون مقایسه کنیم.
با تکرار این نوع تمرین روی متنهای فراوان، مدل میتونه الگوهای زبان و ارتباط بخشهای مختلف متن رو یاد بگیره.
پس در یادگیری خودنظارتی، پاسخ تمرین از خود داده به دست میاد و لازم نیست انسان برای تکتک نمونهها برچسب جداگانه تعیین کنه.
این روش در آموزش اولیه بسیاری از مدلهای زبانی امروزی کاربرد داره.
۴. یادگیری تقویتی (Reinforcement Learning)
این بار فرض کن میخوایم به یک سیستم یاد بدیم در محیطی شبیهسازیشده، مسیر مناسبی برای حرکت یک ربات پیدا کنه.
ربات میتونه حرکتهای مختلفی انجام بده.
اگر به مقصد نزدیکتر بشه یا به مقصد برسه، ممکنه پاداش دریافت کنه. اگر با مانع برخورد کنه، ممکنه جریمه بشه.
سیستم با انجام اقدامهای مختلف و بررسی پاداشهایی که دریافت میکنه، یاد میگیره چه تصمیمهایی در طول زمان نتیجه بهتری دارن.
اینجا قرار نیست برای هر حرکت، مثل مثال تعمیر کولر، یک جواب عددی درست در اختیار مدل بذاریم.
در یادگیری تقویتی، سیستم از نتیجه اقدامها و پاداشها برای بهترکردن روش تصمیمگیری خودش استفاده میکنه.
تفاوت این چهار روش در یک نگاه
| روش یادگیری | مدل از چه چیزی برای یادگیری استفاده میکند؟ |
|---|---|
| نظارتشده | نمونهها همراه با جواب درست |
| بدون نظارت | الگوها و ساختارهای موجود در دادهها، بدون جواب آماده |
| خودنظارتی | تمرینها و پاسخهایی که از خود داده ساخته میشن |
| تقویتی | نتیجه اقدامها و پاداشهای دریافتی |
آیا همه این روشها از گرادیان کاهشی استفاده میکنن؟
نه. گرادیان کاهشی یکی از روشهای مهم اصلاح پارامترهاست، اما همه الگوریتمهای یادگیری از اون استفاده نمیکنن.
همچنین ممکنه در آموزش یک سیستم پیشرفته، چند روش یادگیری در مراحل مختلف به کار بره.
حالا میدونیم هوش مصنوعی فقط به یک روش یاد نمیگیره.
اما یک سؤال دیگه باقی مونده: آیا همه مدلها اطلاعات رو به یک شکل پردازش میکنن؟
مثلاً مدلی که تعداد درخواستهای تعمیر رو پیشبینی میکنه، با مدلی که چهره رو تشخیص میده یا متن تولید میکنه، چه تفاوتی داره؟
برای فهمیدن این موضوع، باید ببینیم مدلهای مختلف چطور از اطلاعات به نتیجه میرسن و شبکههای عصبی مصنوعی چه نقشی در این فرایند دارن.
آیا همه مدلهای هوش مصنوعی به یک روش نتیجه میرسند؟
تا اینجا یاد گرفتیم که بعضی مدلهای هوش مصنوعی با بررسی دادهها و اصلاح پارامترها آموزش میبینن. اما آیا همه مدلها بعد از آموزش هم اطلاعات رو به یک شکل پردازش میکنن؟
نه. مدلهای مختلف میتونن برای رسیدن به نتیجه، محاسبات متفاوتی انجام بدن.
برای اینکه این تفاوت رو بفهمیم، اول با دو مدل ساده آشنا میشیم و بعد سراغ شبکههای عصبی میریم.
۱. مدلهایی که رابطه بین عددها را یاد میگیرند
یادت هست برای پیشبینی تعداد درخواستهای تعمیر کولر از چه فرمولی استفاده کردیم؟
تعداد درخواستهای پیشبینیشده = دمای هوا × پارامتر
مثلاً با دمای ۳۰ درجه و پارامتر ۲، مدل تعداد ۶۰ درخواست رو پیشبینی میکرد.
حالا فرض کن بخوایم علاوه بر دمای هوا، عوامل دیگهای مثل تعطیلات رو هم وارد محاسبات کنیم.
میتونیم مدلی داشته باشیم که برای هر عامل یک ضریب در نظر بگیره و با ترکیب اونها، تعداد درخواستها رو پیشبینی کنه.
یکی از روشهای شناختهشده برای این کار، رگرسیون خطی (Linear Regression) هست.
در این روش، مدل با استفاده از دادههای آموزشی، ضرایبی رو یاد میگیره که بتونه رابطه خطی بین ورودیها و نتیجه رو نمایش بده.
اما همه مسئلهها رو نمیشه با یک رابطه خطی مناسب توضیح داد.
۲. مدلهایی که از مسیر سؤالهای مختلف به نتیجه میرسند
حالا فرض کن یک شرکت خدماتی میخواد درخواستهای مشتریان رو براساس میزان فوریت دستهبندی کنه.
یکی از مدلهایی که میتونیم برای این کار استفاده کنیم، درخت تصمیم (Decision Tree) هست.
درخت تصمیم رو شبیه یک مسیر چندشاخه تصور کن.
مثلاً یک درخت آموزشدیده ممکنه برای بررسی درخواست جدید، ابتدا بپرسه:
«آیا دستگاه کاملاً از کار افتاده؟»
اگر جواب بله باشه، از یک شاخه جلو میره و اگر نه، از شاخه دیگه.
در مرحله بعد ممکنه بررسی کنه:
«آیا خرابی باعث توقف یک فعالیت ضروری شده؟»
مدل با عبور از این شاخهها، در نهایت به نتیجهای مثل «فوریت بالا» یا «فوریت معمولی» میرسه.
اما یک سؤال مهم وجود داره: چه کسی مشخص کرده مدل باید چه سؤالهایی بپرسه؟
در یک درخت تصمیمِ یادگیرنده، الگوریتم آموزش، دادههای قبلی رو بررسی میکنه و تصمیم میگیره کدوم ویژگیها و تقسیمبندیها برای جداکردن دستهها مناسبترن.
پس برخلاف یک برنامه قانونمحور معمولی، لازم نیست انسان تمام سؤالها و شاخههای درخت رو خودش بنویسه.
نکته جالب اینه که روش رسیدن به نتیجه در این مدل با رگرسیون خطی فرق داره.
در رگرسیون خطی، ورودیها با ضرایب مشخصی ترکیب میشن؛ اما درخت تصمیم براساس ویژگیهای ورودی، مسیر مشخصی رو بین شاخهها دنبال میکنه.
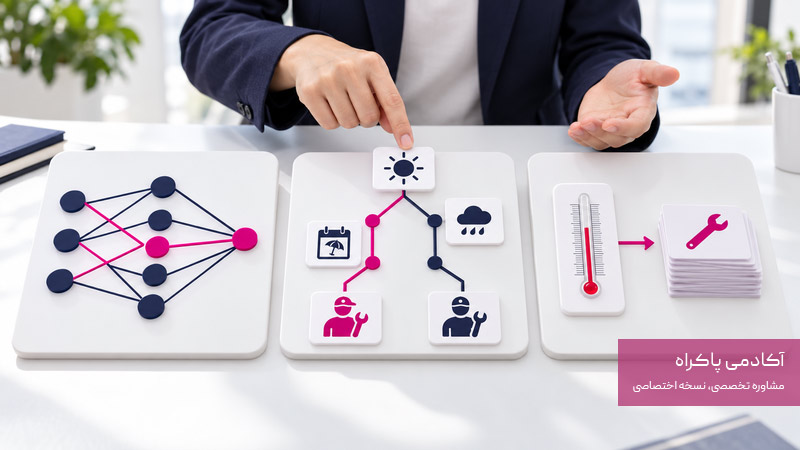
۳. شبکه عصبی مصنوعی چگونه کار میکند؟
حالا فرض کن میخوایم هوش مصنوعی رو آموزش بدیم تا از روی عکس، ایراد ظاهری یک محصول رو تشخیص بده.
برای این کار ممکنه لازم باشه ارتباط بخشهای زیادی از تصویر بررسی بشه؛ مثلاً شکل، لبهها، بافت و تفاوتهای ظریف محصول سالم و معیوب.
چطور میتونیم مدلی بسازیم که چنین رابطههای پیچیدهای رو یاد بگیره؟
یکی از راهها، استفاده از شبکه عصبی مصنوعی (Artificial Neural Network) هست.
شبکه عصبی از واحدهای محاسباتی به نام نورون مصنوعی (Artificial Neuron) تشکیل شده که در لایههای مختلف به هم متصل هستن.
هر نورون عددهایی رو دریافت میکنه، محاسباتی روی اونها انجام میده و خروجی رو به بخش بعدی شبکه میفرسته.
اما این محاسبات دقیقاً چطور انجام میشن؟
نورون مصنوعی چگونه اطلاعات را محاسبه میکند؟
برای اینکه مفهوم نورون رو بفهمیم، یک مثال سادهتر از تصویر انتخاب کنیم.
فرض کن میخوایم پیام مشتری رو بررسی کنیم و تشخیص بدیم آیا نشانهای از نارضایتی در اون وجود داره یا نه.
این پیام رو در نظر بگیر:
«تعمیرکار هنوز نیومده، لطفاً پیگیری کنید.»
ما با خوندن پیام متوجه میشیم مشتری درباره تأخیر صحبت میکنه.
برای سادهکردن مثال، فرض میکنیم دو ویژگی پیام رو از قبل به عدد تبدیل کردیم:
- ویژگی اول: آیا پیام به تأخیر اشاره کرده؟ اگر بله ۱، اگر نه ۰.
- ویژگی دوم: آیا درخواست بازگشت وجه وجود داره؟ اگر بله ۱، اگر نه ۰.
در پیام ما، ویژگی اول ۱ و ویژگی دوم ۰ هست.
حالا نورون باید با این دو عدد محاسبه انجام بده.
برای این کار از دو عدد قابلتنظیم استفاده میکنه:
وزن (Weight): مشخص میکنه هر ورودی چه اثری روی محاسبه داشته باشه.
بایاس (Bias): عددیه که به مجموع محاسبات اضافه میشه و نتیجه رو تغییر میده.
فرض کن نورون ما این تنظیمات رو داره:
| بخش | مقدار فرضی |
|---|---|
| وزن تأخیر | ۲ |
| وزن بازگشت وجه | ۳ |
| بایاس | ۱− |
حالا هر ورودی در وزن خودش ضرب میشه و بایاس به نتیجه اضافه میشه:
(۱ × ۲) + (۰ × ۳) − ۱ = ۱
پس حاصل محاسبه اولیه نورون برابر ۱ شده.
اما هنوز یک مرحله باقی مونده.
تابع فعالسازی چه کاری انجام میدهد؟
نورون معمولاً نتیجه محاسبه اولیه رو از تابعی به نام تابع فعالسازی (Activation Function) عبور میده.
شاید بپرسی چرا؟
چون اگر شبکه فقط از جمع و ضربهای خطی استفاده کنه، حتی با اضافهکردن چندین لایه هم نمیتونه بعضی رابطههای غیرخطی رو یاد بگیره.
تابعهای فعالسازی غیرخطی به شبکه کمک میکنن رابطههای پیچیدهتری رو نمایش بده.
یکی از تابعهای ساده و پرکاربرد، ReLU هست.
کارش چیه؟
اگر عدد ورودی مثبت باشه، همون عدد رو عبور میده. اگر صفر یا منفی باشه، خروجی رو صفر میکنه.
در مثال ما، نتیجه اولیه نورون ۱ بود؛ پس خروجی ReLU هم ۱ میشه.
حالا فرض کن وزن تأخیر از ۲ به ۰٫۵ تغییر کنه.
محاسبه جدید:
(۱ × ۰٫۵) + (۰ × ۳) − ۱ = ۰٫۵−
چون نتیجه منفیه، خروجی ReLU برابر صفر میشه.
دیدی چه اتفاقی افتاد؟
بدون اینکه متن پیام یا ویژگیهای ورودی تغییر کنن، فقط با تغییر یک وزن، خروجی نورون از ۱ به صفر رسید.
این همون مفهومیه که در مثال تعمیر کولر یاد گرفتیم: پارامترهای مدل روی نتیجه محاسبات اثر میذارن.
البته خروجی ۱ یا صفر این نورون بهتنهایی به معنی تشخیص قطعی رضایت یا نارضایتی مشتری نیست. در یک شبکه واقعی، خروجی نورونها میتونه وارد محاسبات بعدی بشه تا مدل در نهایت نتیجه موردنظر رو تولید کنه.
همچنین در این مثال ویژگیهای پیام رو خودمون عددگذاری کردیم؛ اما شبکههای پیشرفته پردازش زبان میتونن نمایشهای عددی پیچیدهتری از خود متن بسازن.
لایههای شبکه عصبی چه کاری انجام میدهند؟
تا اینجا فقط یک نورون رو بررسی کردیم.
اما برای انجام کارهای پیچیدهتر، معمولاً نورونهای زیادی در چند لایه به هم متصل میشن.
در یک شبکه عصبی پیشخور ساده، مسیر پردازش اطلاعات رو میتونیم به سه قسمت تقسیم کنیم:
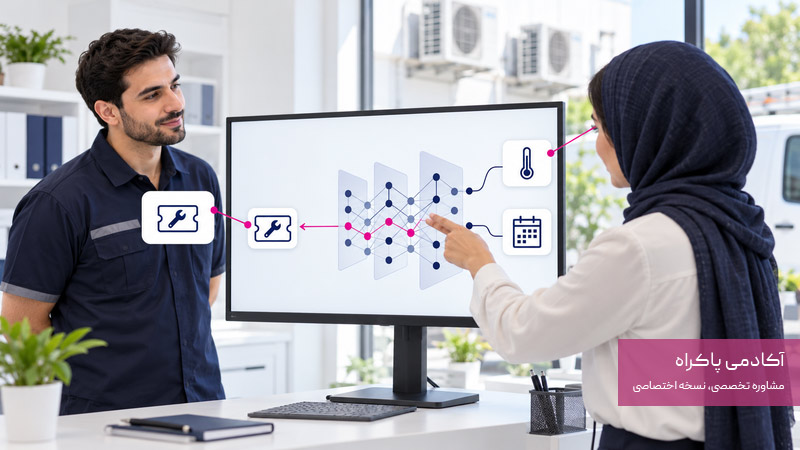
۱. لایه ورودی (Input Layer): اطلاعات عددی اولیه رو دریافت میکنه.
۲. لایههای پنهان (Hidden Layers): اطلاعات رو در چند مرحله پردازش میکنن. خروجی یک لایه به لایه بعدی منتقل میشه.
۳. لایه خروجی (Output Layer): نتیجه نهایی مدل رو تولید میکنه.
حالا به مثال تشخیص نارضایتی مشتری برگردیم.
فرض کن متن پیام به نمایش عددی مناسبی تبدیل شده و وارد شبکه عصبی میشه.
در لایههای مختلف، نورونها با استفاده از وزنها، بایاسها و تابعهای فعالسازی محاسباتی انجام میدن.
در نهایت، لایه خروجی میتونه امتیازی برای نارضایتی پیام تولید کنه.
مثلاً یک مدل دستهبندی که برای ارائه احتمال طراحی و بهدرستی ارزیابی شده، ممکنه احتمال نارضایتی رو ۹۰ درصد اعلام کنه.
اما شبکه چطور یاد گرفته که کدوم وزنها برای تشخیص نارضایتی مناسبترن؟
اینجا دوباره به همون مسئله آموزش و اصلاح خطا میرسیم.
شبکه عصبی چگونه وزنهای خودش را اصلاح میکند؟
یادت هست برای مدل پیشبینی تعمیر کولر، یک پارامتر داشتیم؟
برنامه آموزشی خطا رو حساب میکرد و با کمک گرادیان کاهشی، پارامتر رو تغییر میداد.
اما شبکه عصبی ممکنه هزاران یا میلیونها وزن و بایاس داشته باشه.
فرض کن شبکه، پیام مشتری ناراضی رو بررسی کرده، اما بهاشتباه امتیاز نارضایتی پایینی داده.
برنامه آموزشی ابتدا نتیجه مدل رو با پاسخ درست مقایسه و خطا رو محاسبه میکنه.
حالا سؤال اینه:
از کجا بفهمیم کدوم وزنها باعث این خطا شدن و هرکدوم باید چقدر تغییر کنن؟
در بسیاری از شبکههای عصبی، از روشی به نام پسانتشار (Backpropagation) استفاده میکنیم.
پسانتشار با استفاده از محاسبات ریاضی، اثر هر پارامتر رو بر خطای نهایی محاسبه میکنه.
برای این کار، محاسبات مشتق از بخش خروجی شبکه به سمت لایههای قبلی انجام میشن.
بعد الگوریتم بهینهسازی، مثل گرادیان کاهشی، از این اطلاعات برای اصلاح وزنها و بایاسها استفاده میکنه.
بیا تفاوتشون رو با یک مثال ذهنی مرور کنیم.
فرض کن نتیجه یک محاسبه اشتباه شده و چندین عدد مختلف روی اون تأثیر داشتن.
اول باید بفهمی تغییر هر عدد چه اثری روی اشتباه نهایی داره.
این کاریه که پسانتشار به محاسبه اون کمک میکنه.
بعد باید تصمیم بگیری هر عدد رو چقدر تغییر بدی تا خطا کمتر بشه.
این کار رو الگوریتم بهینهسازی با استفاده از گرادیانهای محاسبهشده انجام میده.
پس این دو مفهوم یکسان نیستن:
- پسانتشار: اثر پارامترهای مختلف روی خطا رو محاسبه میکنه.
- گرادیان کاهشی: از گرادیانهای محاسبهشده برای اصلاح پارامترها در جهت کاهش خطا استفاده میکنه.
این فرایند در طول آموزش با نمونههای مختلف تکرار میشه.
به این ترتیب، شبکه میتونه وزنها و بایاسهای خودش رو طوری تنظیم کنه که الگوهای مفیدتری از دادههای آموزشی یاد بگیره.
آیا تمام مدلهای هوش مصنوعی شبکه عصبی دارند؟
نه. همانطور که دیدیم، رگرسیون خطی و درخت تصمیم هم میتونن با دادهها آموزش ببینن و به نتیجه برسن.
همچنین شبکههای عصبی مختلف، معماریها و روشهای آموزش متفاوتی دارن. شبکههای عمیق در بسیاری از سیستمهای پیشرفته پردازش متن، تصویر و صدا کاربرد دارن، اما تنها روش ساخت هوش مصنوعی نیستن.
حالا میدونیم مدلهای مختلف چطور به نتیجه میرسن و شبکه عصبی چگونه میتونه تنظیماتش رو هنگام آموزش اصلاح کنه.
اما یک سؤال مهم باقی مونده:
اگر مدل روی اطلاعات آموزشی نتیجه خوبی داشته باشه، از کجا مطمئن بشیم اطلاعات رو فقط حفظ نکرده و میتونه روی نمونههای جدید هم درست کار کنه؟
برای جواب، باید ببینیم عملکرد مدل رو چطور آزمایش و ارزیابی میکنیم.
از کجا بفهمیم هوش مصنوعی واقعاً یاد گرفته است؟
تا اینجا دیدیم مدل چطور آموزش میبینه و با اصلاح پارامترها، خطای خودش رو کمتر میکنه.
اما یک سؤال مهم داریم: اگر مدل روی اطلاعات آموزشی خیلی خوب عمل کنه، آیا میتونیم مطمئن باشیم روی اطلاعات جدید هم درست پیشبینی میکنه؟
نه لزوماً!
فرض کن مدل پیشبینی درخواستهای تعمیر کولر رو با اطلاعات دو سال گذشته آموزش دادیم و حالا میتونه تعداد درخواستهای همون روزها رو با خطای بسیار کمی پیشبینی کنه.
این نتیجه امیدوارکنندهست، اما ما مدل رو برای پیشبینی روزهای گذشته نساختیم؛ میخوایم بدونیم فردا چند درخواست دریافت میکنیم.
پس باید بررسی کنیم مدل در شرایطی که قبلاً ندیده، چطور عمل میکنه.
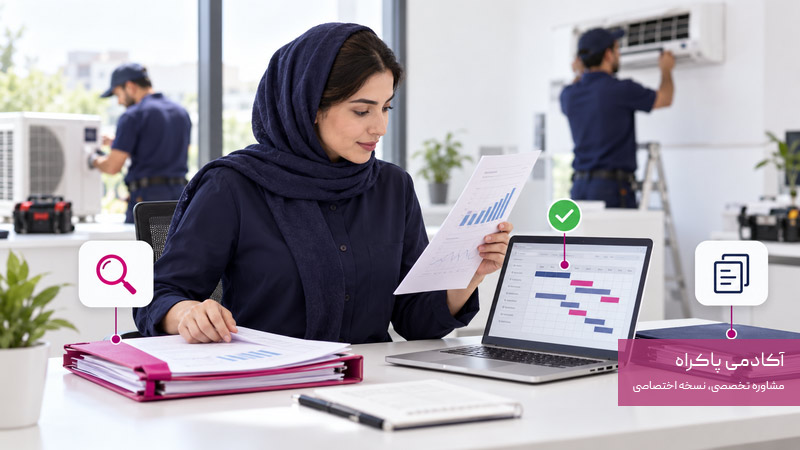
۱. دادههای آموزشی، اعتبارسنجی و آزمایشی چه تفاوتی دارند؟
برای اینکه مدل رو درست ارزیابی کنیم، معمولاً دادهها رو به سه گروه تقسیم میکنیم.
| نوع داده | کاربرد |
|---|---|
| داده آموزشی (Training Data) | مدل با استفاده از این اطلاعات آموزش میبینه و پارامترهاش اصلاح میشن. |
| داده اعتبارسنجی (Validation Data) | هنگام توسعه مدل بررسی میکنیم کدوم تنظیمات و روشها نتیجه بهتری دارن. |
| داده آزمایشی (Test Data) | بعد از انتخاب مدل و تنظیماتش، عملکرد نهایی رو روی اطلاعات کنارگذاشتهشده میسنجیم. |
بیا ببینیم چرا به این تقسیمبندی نیاز داریم.
فرض کن اطلاعات درخواستهای تعمیر کولر رو برای دو سال گذشته داریم.
بخشی از روزهای قدیمیتر رو برای آموزش استفاده میکنیم. بعد، عملکرد مدل رو روی یک بازه جدیدتر بررسی میکنیم و اگر لازم بود، تنظیماتش رو تغییر میدیم.
اما برای آزمایش نهایی، اطلاعات بازه دیگری رو کنار میذاریم که در آموزش و انتخاب تنظیمات مدل استفاده نشده.
حالا اگر مدل روی این دادهها هم عملکرد مناسبی داشته باشه، دلیل بهتری داریم که فکر کنیم چیزی فراتر از حفظکردن نمونههای آموزشی یاد گرفته.
یک نکته مهم: در پیشبینیهای زمانی، نباید اطلاعات آینده رو برای آموزش پیشبینیِ گذشته استفاده کنیم.
مثلاً اگر میخوایم تعداد درخواستهای فردا رو پیشبینی کنیم، نمیتونیم از تعداد واقعی درخواستهای فردا بهعنوان یکی از ورودیهای همون پیشبینی استفاده کنیم.
به چنین اشتباههایی که اطلاعاتِ خارج از دسترسِ زمان پیشبینی وارد آموزش یا ارزیابی میشن، نشت داده (Data Leakage) میگن.
این اتفاق ممکنه باعث بشه مدل در آزمایش خیلی دقیق به نظر برسه، اما در استفاده واقعی نتیجه ضعیفی بده.
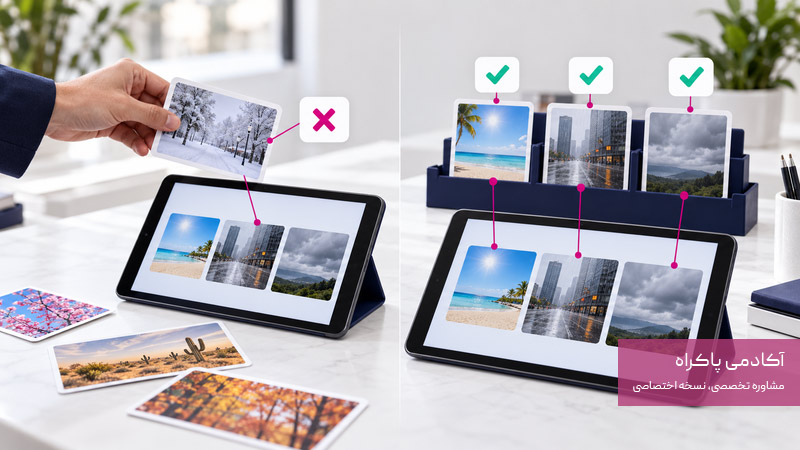
۲. چرا ممکن است مدل فقط نمونههای آموزشی را حفظ کند؟
فرض کن دانشآموزی جواب تمام سؤالهای یک برگه امتحانی رو حفظ کرده.
اگر دوباره همون سؤالها رو بهش بدی، احتمالاً نمره خوبی میگیره.
اما اگر سؤالها کمی تغییر کنن، ممکنه نتونه جواب بده.
در یادگیری ماشین هم گاهی اتفاق مشابهی میافته.
مثلاً مدل پیشبینی درخواستهای تعمیر کولر ممکنه علاوه بر رابطههای مفید، بعضی اتفاقات تصادفی روزهای گذشته رو هم یاد بگیره.
در نتیجه، روی دادههای آموزشی عملکرد فوقالعادهای داره، اما برای روزهای جدید اشتباهات زیادی انجام میده.
به این مشکل بیشبرازش (Overfitting) میگن.
در مقابل، ممکنه مدل اونقدر ساده یا نامناسب باشه که حتی نتونه رابطههای مهم دادههای آموزشی رو یاد بگیره.
به این حالت کمبرازش (Underfitting) میگیم.
پس هدف ما چیه؟
میخوایم مدل رابطههایی رو یاد بگیره که روی اطلاعات جدید هم کاربرد داشته باشن، نه اینکه فقط برای نمونههای گذشته جواب درست تولید کنه.
به این توانایی، تعمیمپذیری (Generalization) میگن.
۳. دقت مدل را چگونه اندازه میگیریم؟
حالا فرض کن مدل رو با دادههای جدید آزمایش کردیم.
از کجا بفهمیم نتیجه خوبه یا بد؟
بستگی داره مدل چه کاری انجام میده.
وقتی مدل یک عدد پیشبینی میکند
به مثال تعمیر کولر برگردیم.
فرض کن مدل برای سه روز آزمایشی، این نتایج رو داده:
| درخواستهای واقعی | پیشبینی مدل |
|---|---|
| ۸۰ | ۷۰ |
| ۱۰۰ | ۱۰۵ |
| ۶۰ | ۵۵ |
حالا اختلاف هر پیشبینی رو حساب کنیم:
- روز اول: ۱۰ درخواست اختلاف
- روز دوم: ۵ درخواست اختلاف
- روز سوم: ۵ درخواست اختلاف
اگر بخوایم بدونیم مدل بهطور میانگین چند درخواست اشتباه پیشبینی کرده، اندازه این اختلافها رو جمع میکنیم و بر تعداد روزها تقسیم میکنیم:
(۱۰ + ۵ + ۵) ÷ ۳ ≈ ۶٫۷
یعنی مدل در این سه روز، بهطور میانگین حدود ۶٫۷ درخواست اختلاف داشته.
به این روش میانگین قدرمطلق خطا (Mean Absolute Error یا MAE) میگن.
شاید بپرسی چرا اینجا از خطای مربعی استفاده نکردیم؟
چون هدفمون الان اینه که اشتباهات مدل رو با یک واحد قابلفهم برای مدیر توضیح بدیم؛ یعنی تعداد درخواستها.
خطای مربعی هم میتونه برای آموزش یا ارزیابی استفاده بشه، اما MAE مستقیماً نشون میده اندازه متوسط اشتباه چقدره.
البته اینکه اختلاف ۶٫۷ درخواست قابلقبوله یا نه، به نیاز کسبوکار بستگی داره.
مثلاً برای برنامهریزی ۵۰۰ درخواست روزانه، ممکنه این اختلاف کم باشه؛ اما برای مجموعهای با ۱۵ درخواست روزانه، میتونه اهمیت زیادی داشته باشه.
وقتی مدل اطلاعات را دستهبندی میکند
حالا فرض کن یک مدل هوش مصنوعی ساختیم که پیامهای مشتریان رو بررسی کنه و شکایتها رو تشخیص بده.
۱۰۰ پیام داریم که فقط ۱۰ موردشون شکایت واقعی هستن.
مدل تمام ۱۰۰ پیام رو بررسی میکنه، اما هیچکدوم رو شکایت تشخیص نمیده!
به نظرت عملکردش چقدره؟
از ۱۰۰ پیام، ۹۰ پیام واقعاً شکایت نبودن. پس مدل ۹۰ مورد رو درست دستهبندی کرده.
یعنی درستی کلی مدل ۹۰ درصده.
شاید در نگاه اول عدد خوبی به نظر برسه.
اما مشکل اینجاست که مدل حتی یک شکایت واقعی رو هم پیدا نکرده!
پس اگر فقط به درستی کلی نگاه کنیم، ممکنه تصور اشتباهی از عملکرد مدل داشته باشیم.
برای ارزیابی چنین مدلهایی، چند معیار مهم وجود داره:
| معیار | چه چیزی را نشان میدهد؟ |
|---|---|
| Accuracy (درستی کلی) | از تمام پیامها، چند مورد درست دستهبندی شدن؟ |
| Precision (دقت تشخیص مثبت) | از پیامهایی که مدل شکایت تشخیص داده، چند مورد واقعاً شکایت بودن؟ |
| Recall (یادآوری) | از تمام شکایتهای واقعی، مدل چند مورد رو پیدا کرده؟ |
در مثال ما، Recall برای دسته شکایت صفر درصده؛ چون هیچکدوم از ۱۰ شکایت واقعی شناسایی نشده.
پس اگر هدف شرکت این باشه که شکایت مشتریان از دست نره، این مدل با وجود درستی کلی ۹۰ درصد، عملکرد مناسبی نداره.
البته اگر مدل تمام پیامها رو شکایت تشخیص بده هم مشکل دیگهای ایجاد میشه؛ چون تیم پشتیبانی باید تعداد زیادی پیام عادی رو بیدلیل بررسی کنه.
پس معیار ارزیابی باید براساس مسئلهای انتخاب بشه که میخوایم حل کنیم.
آیا نتیجه خوب در آزمایش، عملکرد آینده مدل رو تضمین میکنه؟
نه.
آزمایش فقط نشون میده مدل روی دادههای انتخابشده چطور عمل کرده.
اگر شرایط واقعی تغییر کنه، مثلاً رفتار مشتریها یا میزان تقاضای تعمیرات عوض بشه، ممکنه دقت مدل هم کاهش پیدا کنه.
برای همین، حتی بعد از شروع استفاده واقعی باید عملکرد مدل رو بررسی کنیم و در صورت نیاز، اون رو با دادههای جدید بهروزرسانی کنیم.
حالا میدونیم چطور مدل رو آموزش بدیم و بررسی کنیم که روی اطلاعات جدید هم عملکرد مناسبی داره.
اما وقتی آموزش و ارزیابی تموم شد، چه اتفاقی میافته؟
وقتی فردا مدیر شرکت دمای هوا رو وارد میکنه و از مدل تعداد درخواستها رو میپرسه، آیا مدل دوباره تمام مراحل آموزش رو طی میکنه؟
برای جواب، باید تفاوت آموزش مدل با استفاده از مدل آموزشدیده رو بشناسیم.
هوش مصنوعی بعد از آموزش چگونه پاسخ میدهد؟
تا اینجا دیدیم که مدل چطور از دادهها یاد میگیره، پارامترهاش اصلاح میشن و عملکردش رو روی اطلاعات جدید آزمایش میکنیم.
اما حالا فرض کن آموزش تموم شده و مدل آماده استفادهست.
مدیر شرکت تعمیراتی میخواد بدونه فردا چند درخواست تعمیر کولر دریافت میکنه.
آیا مدل باید دوباره اطلاعات دو سال گذشته رو بررسی کنه و از اول آموزش ببینه؟
نه. مدل میتونه از تنظیماتی که قبلاً یاد گرفته، برای پردازش اطلاعات جدید استفاده کنه.
به این مرحله «استنتاج» میگیم.
۱. استنتاج (Inference) چیست؟
استنتاج (Inference) یعنی مدل آموزشدیده اطلاعات جدیدی رو دریافت کنه و با استفاده از تنظیماتش، نتیجهای مثل پیشبینی، تشخیص یا پاسخ تولید کنه.
بیا به مثال شرکت تعمیراتی برگردیم.
فرض کن مدل رو با اطلاعات دو سال گذشته آموزش دادیم و بعد از آزمایش، به این نتیجه رسیدیم که عملکردش برای برنامهریزی شرکت قابلقبوله.
حالا مدیر میخواد تعداد درخواستهای فردا رو بدونه.
اطلاعاتی رو که مدل برای پیشبینی نیاز داره، در اختیارش میذاریم:
- دمای پیشبینیشده فردا
- روز هفته
- تعطیلبودن یا نبودن
- سایر اطلاعاتی که مدل برای استفاده از اونها آموزش دیده
مدل این اطلاعات رو دریافت میکنه، محاسباتش رو انجام میده و مثلاً نتیجه میده:
«تعداد درخواستهای پیشبینیشده: ۱۲۰ درخواست»
این عدد فرضیه و ممکنه تعداد واقعی درخواستهای فردا متفاوت باشه.
اما نکته مهم اینه که مدل برای تولید این پیشبینی، دوباره از ابتدا آموزش ندیده؛ از تنظیمات آموزشدیده خودش استفاده کرده.
۲. آموزش مدل چه تفاوتی با استفاده از آن دارد؟
شاید بپرسی وقتی در هر دو مرحله مدل محاسبه انجام میده، پس تفاوتشون چیه؟
تفاوت اصلی در هدف محاسباته.
| آموزش مدل (Training) | استفاده از مدل (Inference) |
|---|---|
| مدل با دادههای آموزشی کار میکنه. | مدل اطلاعات جدید رو دریافت میکنه. |
| در روش مثال ما، پیشبینی با جواب واقعی مقایسه میشه. | مدل براساس تنظیماتش نتیجه رو محاسبه میکنه. |
| پارامترها برای کاهش خطا اصلاح میشن. | پارامترهای آموزشدیده معمولاً ثابت میمونن. |
| هدف، یادگرفتن الگوهای مفیده. | هدف، استفاده از الگوهای یادگرفتهشدهست. |
برای همین، وقتی از ChatGPT یک سؤال میپرسی، نباید تصور کنی مدل با هر پیام دوباره تمام مراحل آموزش اولیه خودش رو انجام میده.
مدل میتونه از اطلاعات گفتوگوی فعلی برای ساخت پاسخ استفاده کنه، بدون اینکه لزوماً پارامترهای اصلیش تغییر کنن.
اما اینجا یک سؤال جدید پیش میاد:
مدل پیشبینی تعمیر کولر با عددها کار میکرد. ChatGPT چطور نوشته ما رو دریافت میکنه و جواب میده؟
۳. ChatGPT چگونه درخواست ما را پردازش میکند؟
فرض کن این سؤال رو در ChatGPT مینویسی:
«چرا وقتی هوا گرم میشه، درخواست تعمیر کولر بیشتر میشه؟»
ما با خوندن این جمله متوجه منظورش میشیم.
اما مدل زبانی برای پردازش درخواست، باید متن رو به شکلی تبدیل کنه که بتونه روی اون محاسبات ریاضی انجام بده.
بیا مراحل رو ساده بررسی کنیم.
مرحله اول: متن به بخشهای کوچکتری تقسیم میشود
در بسیاری از مدلهای زبانی، متن به قسمتهایی به نام توکن (Token) تقسیم میشه.
توکن ممکنه یک کلمه، بخشی از یک کلمه یا یک نشانه باشه.
مثلاً جمله ما به چندین توکن تبدیل میشه. تعداد و مرز این توکنها به روش تقسیم متن در مدل بستگی داره.
بعد هر توکن به یک شناسه عددی تبدیل میشه.
اما آیا مدل فقط با دیدن چند عدد میتونه منظور جمله رو بفهمه؟
هنوز نه.
مرحله دوم: مدل ارتباط بخشهای متن را بررسی میکند
شناسههای عددی به نمایشهای عددی مناسبتری تبدیل میشن تا مدل بتونه روابط بین بخشهای متن رو پردازش کنه.
در بسیاری از مدلهای زبانی امروزی، ساختاری به نام ترانسفورمر (Transformer) استفاده میشه.
یکی از سازوکارهای مهم این ساختار، توجه (Attention) هست.
برای اینکه مفهومش رو بفهمیم، به این دو جمله دقت کن:
«تعمیرکار به مشتری گفت دستگاه رو خاموش کنه.»
«مشتری به تعمیرکار گفت دستگاه رو خاموش کنه.»
کلمات دو جمله تقریباً یکسانن، اما چه کسی به چه کسی دستور داده؟
در جمله اول، تعمیرکار به مشتری گفته دستگاه رو خاموش کنه.
در جمله دوم، مشتری به تعمیرکار گفته دستگاه رو خاموش کنه.
پس فقط شناختن تکتک کلمات کافی نیست؛ ارتباط و جایگاه اونها هم اهمیت داره.
سازوکار توجه به مدل کمک میکنه هنگام پردازش هر بخش از متن، اطلاعات بخشهای مرتبط دیگه رو هم در محاسباتش در نظر بگیره.
البته این به معنی توجه آگاهانه مثل انسان نیست؛ مجموعهای از محاسبات ریاضیه که مدل در طول آموزش، تنظیماتش رو یاد گرفته.
مرحله سوم: مدل پاسخ را بهتدریج تولید میکند
حالا مدل درخواست رو پردازش کرده و باید جواب بده.
اما آیا یک متن کامل و آماده درون مدل وجود داره که فقط اون رو پیدا کنه؟
نه لزوماً.
یک مدل زبانی مولد، با استفاده از متن درخواست، زمینه گفتوگو و الگوهایی که در زمان آموزش یاد گرفته، احتمال توکنهای مختلف رو برای ادامه پاسخ محاسبه میکنه.
بعد براساس روش تولید پاسخ، توکن بعدی انتخاب میشه.
این فرایند تکرار میشه و پاسخ بهتدریج شکل میگیره.
مثلاً ممکنه پاسخ با این جمله شروع بشه:
«وقتی دمای هوا افزایش پیدا میکنه، استفاده از کولرها هم معمولاً بیشتر میشه…»
مدل با توجه به متنی که تا اون لحظه تولید کرده، ادامه پاسخ رو میسازه.
پس پاسخدادن مدل زبانی، معمولاً پیدا کردن یک جواب آماده از حافظه نیست؛ تولید تدریجی متن با استفاده از محاسبات و الگوهای آموزشدیدهست.
البته بعضی ابزارهای گفتوگومحور میتونن به جستوجوی اینترنتی، فایلها یا ابزارهای دیگه هم متصل بشن و از اطلاعات اونها برای پاسخدادن کمک بگیرن.
آیا چون ChatGPT میتونه پاسخ روان تولید کنه، پس حتماً جوابش درسته؟
نه.
مدل ممکنه متنی تولید کنه که از نظر زبانی کاملاً طبیعی باشه، اما اطلاعات نادرستی داشته باشه.
چون تولید پاسخ روان و درستبودن اطلاعات، دو موضوع متفاوتن.
۴. هوش مصنوعی چگونه تصویر را تشخیص میدهد یا تصویر جدید میسازد؟
تا اینجا درباره مدلهایی صحبت کردیم که با عدد یا متن کار میکنن.
اما وقتی یک تصویر به هوش مصنوعی میدیم، چه اتفاقی میافته؟
یک تصویر دیجیتال از پیکسلهایی تشکیل شده که مقدارهای عددی مربوط به رنگ و روشنایی دارن.
مدل مناسب میتونه این اطلاعات رو پردازش کنه و براساس الگوهایی که یاد گرفته، اشیای داخل تصویر رو تشخیص بده.
مثلاً فرض کن از یک محصول معیوب عکس گرفتیم.
یک مدل تشخیص تصویر میتونه تصویر رو بررسی کنه و احتمال وجود ایراد ظاهری رو مشخص کنه.
اما اگر از هوش مصنوعی بخوایم تصویر جدیدی بسازه، کار متفاوت میشه.
در این حالت از هوش مصنوعی مولد (Generative AI) استفاده میکنیم.
مثلاً میگیم:
«تصویر یک دستگاه قهوهساز روی میز چوبی در آشپزخانهای روشن بساز.»
مدل تصویرساز از الگوهایی که هنگام آموزش یاد گرفته برای تولید تصویر استفاده میکنه.
بعضی مدلهای تصویرساز از فرایندی شبیه کاهش تدریجی نویز استفاده میکنن؛ یعنی از یک حالت نویزی شروع میکنن و طی چند مرحله تصویری متناسب با درخواست میسازن.
البته همه مدلهای تصویرساز به یک روش کار نمیکنن.
پس باید دو مفهوم رو از هم جدا کنیم:
- تشخیص تصویر: مدل اطلاعات موجود در یک تصویر رو بررسی میکنه.
- تولید تصویر: مدل براساس درخواست و الگوهای آموزشدیده، تصویر تازهای میسازه.
این تفاوت رو در مقاله «هوش مصنوعی مولد چیست؟» با مثالهای بیشتری توضیح دادیم.
۵. آیا هوش مصنوعی هر بار که از آن استفاده میکنیم، چیزی یاد میگیرد؟
اینجا ممکنه یک برداشت اشتباه پیش بیاد.
فرض کن چند بار با ChatGPT صحبت کردی و در طول گفتوگو توضیح دادی که صاحب یک شرکت تعمیراتی هستی.
حالا در پیام بعدی میپرسی:
«برای هفته آینده چه محتواهایی پیشنهاد میدی؟»
ممکنه ابزار پیشنهادهایی متناسب با شرکت تعمیراتی ارائه بده.
آیا این یعنی مدل دوباره آموزش دیده؟
نه لزوماً.
مدل میتونه از اطلاعات موجود در گفتوگو یا اطلاعاتی که ابزار در اختیارش قرار میده، برای ساخت پاسخ استفاده کنه.
این با تغییر پارامترهای مدل در فرایند آموزش تفاوت داره.
البته بعضی سیستمهای هوش مصنوعی برای یادگیری مداوم یا بهروزرسانی دورهای طراحی میشن، اما نباید این قابلیت رو به تمام مدلها تعمیم بدیم.
تا اینجا دو مرحله اصلی رو شناختیم:
- آموزش: تنظیمات مدل با استفاده از دادهها و روش آموزشی مشخص، یاد گرفته یا اصلاح میشن.
- استنتاج: مدل با استفاده از تنظیمات آموزشدیده، اطلاعات جدید رو پردازش میکنه و خروجی میده.
این تفاوت برای فهمیدن نحوه کار بسیاری از سیستمهای هوش مصنوعی ضروریه.
حالا میدونیم هوش مصنوعی چطور آموزش میبینه و بعد از آموزش چطور نتیجه تولید میکنه.
اما یک سؤال مهم باقی مونده: اگر تمام این مراحل با محاسبات ریاضی انجام میشن، چرا هوش مصنوعی گاهی جواب اشتباه میده یا نتیجهای تولید میکنه که اصلاً واقعیت نداره؟
برای پاسخ، باید دلایل خطای مدلها رو بررسی کنیم.
چرا هوش مصنوعی گاهی اشتباه میکند؟
تا اینجا یاد گرفتیم که هوش مصنوعی چطور با دادهها آموزش میبینه، خطاهاش رو کمتر میکنه و از اطلاعات جدید به نتیجه میرسه.
اما اگر همه این مراحل رو درست انجام بدیم، آیا میتونیم مطمئن باشیم مدل همیشه جواب درستی میده؟
نه. حتی یک مدل خوب هم ممکنه اشتباه کنه.
برای اینکه دلیلش رو بفهمیم، باید ببینیم خطا در کدوم قسمت از فرایند اتفاق میافته.
۱. اطلاعات آموزشی اشتباه یا ناقص هستند
یادت هست در مثال شرکت تعمیراتی، تعداد درخواستهای یک روز بهجای ۸۰ مورد، ۸۰۰ مورد ثبت شده بود؟
اگر این اشتباه وارد دادههای آموزشی بشه، ممکنه مدل رابطه نادرستی بین دمای هوا و تعداد درخواستها یاد بگیره.
حالا فرض کن تمام اطلاعات درست باشن، اما فقط مربوط به روزهای خنک سال باشن.
آیا میتونیم انتظار داشته باشیم مدل در روزهای بسیار گرم تابستان هم پیشبینی دقیقی انجام بده؟
لزوماً نه؛ چون نمونههای کافی از اون شرایط رو ندیده.
پس هم درستبودن دادهها مهمه و هم اینکه شرایط مختلف مسئله رو بهاندازه کافی پوشش بدن.
۲. مدل رابطه اشتباهی بین اطلاعات یاد میگیرد
فرض کن در یک شرکت، بیشتر درخواستهای تعمیر کولر در روزهای پنجشنبه ثبت شده.
مدل ممکنه یاد بگیره که پنجشنبهها معمولاً تعداد درخواستها بیشتره.
اما آیا خودِ پنجشنبهبودن باعث خرابی بیشتر کولرها میشه؟
نه لزوماً!
شاید مشتریها به دلیل داشتن وقت آزاد، بیشتر در این روز درخواست ثبت میکنن.
اینجا باید یک تفاوت مهم رو بشناسیم:
اینکه دو اتفاق معمولاً با هم رخ میدن، لزوماً به معنی این نیست که یکی باعث اتفاق دیگه شده.
به این موضوع، تفاوت همبستگی (Correlation) و رابطه علت و معلولی (Causation) میگن.
مدلهای یادگیری ماشین میتونن رابطههای آماری رو از دادهها یاد بگیرن، اما این به معنی کشف علت واقعی تمام اتفاقات نیست.
برای همین نباید هر رابطهای رو که مدل پیدا میکنه، بدون بررسی بهعنوان یک واقعیت علت و معلولی بپذیریم.
۳. مدل نسبت به بعضی گروهها سوگیری دارد
فرض کن یک شرکت میخواد از هوش مصنوعی برای بررسی اولیه رزومه متقاضیان استخدام استفاده کنه.
اگر اطلاعات آموزشی مدل بیشتر مربوط به یک گروه خاص از افراد باشه یا تصمیمهای ناعادلانه گذشته رو منعکس کنه، ممکنه مدل هم الگوهای نامناسبی یاد بگیره.
در نتیجه، بعضی متقاضیان ممکنه ناعادلانه ارزیابی بشن.
به چنین مشکلی سوگیری (Bias) میگن.
نکته مهم اینه که مدل لزوماً نمیدونه چه تصمیمی منصفانهست. ممکنه فقط رابطههایی رو یاد گرفته باشه که در اطلاعات آموزشی وجود داشتن.
برای کاهش این مشکل، باید کیفیت و تنوع دادهها، معیارهای ارزیابی و عملکرد مدل برای گروههای مختلف بررسی بشن.
۴. شرایط واقعی بعد از آموزش تغییر میکند
حالا برگردیم به شرکت تعمیراتی.
فرض کن مدل رو با اطلاعات دو سال گذشته آموزش دادیم و در آزمایشها هم نتیجه خوبی گرفتیم.
اما امسال شرکت محدوده خدماتش رو گسترش داده و تعداد متخصصان بیشتری جذب کرده.
آیا رابطهای که مدل از اطلاعات گذشته یاد گرفته، هنوز به همون شکل برقرار میمونه؟
ممکنه نه.
حتی تغییر رفتار مشتریها، شرایط آبوهوایی یا شیوه ثبت درخواست هم میتونه روی نتیجه اثر بذاره.
به تغییر الگوهای داده یا رابطه بین ورودیها و نتیجه در طول زمان، بسته به نوع تغییر، اصطلاحاتی مثل تغییر توزیع داده (Data Drift) و تغییر مفهوم (Concept Drift) گفته میشه.
لازم نیست فعلاً جزئیات این اصطلاحات رو حفظ کنی.
مهم اینه که بدونی مدلی که دیروز خوب کار میکرده، ممکنه با تغییر شرایط امروز به بررسی یا آموزش دوباره نیاز داشته باشه.
۵. هوش مصنوعی مولد ممکن است اطلاعات ساختگی تولید کند
حالا فرض کن از ChatGPT میپرسی:
«سه مقاله علمی درباره تأثیر دمای هوا بر خرابی کولر معرفی کن.»
ممکنه مدل عنوان مقاله، نام نویسنده و حتی سال انتشار رو با ظاهری کاملاً معتبر ارائه بده.
اما وقتی دنبال مقالهها میگردی، متوجه میشی بعضی از اونها اصلاً وجود ندارن!
به تولید چنین اطلاعات نادرست یا ساختگی، توهم هوش مصنوعی (AI Hallucination) میگن.
اما چرا چنین اتفاقی میافته؟
یادت هست گفتیم مدل زبانی با استفاده از الگوهای آموختهشده، پاسخ رو بهتدریج تولید میکنه؟
توانایی تولید متن روان، بهتنهایی تضمین نمیکنه که اطلاعات داخل اون متن درست باشن.
مدل ممکنه پاسخی بسازه که از نظر زبانی طبیعی و باورپذیره، اما با واقعیت مطابقت نداره.
حتی اگر ابزار به اینترنت یا منابع اطلاعاتی متصل باشه، باز هم ممکنه اطلاعات رو اشتباه برداشت کنه یا نتیجه نادرستی ارائه بده.
برای همین، اطلاعات مهم و منابعی که هوش مصنوعی معرفی میکنه باید بررسی بشن.
چطور میتوانیم خطاهای هوش مصنوعی را کمتر کنیم؟
حالا که دلیل بعضی اشتباهات رو شناختیم، ببینیم چه کاری میتونیم انجام بدیم.
| مشکل | راهکار مناسب |
|---|---|
| دادههای اشتباه یا ناقص | بررسی و آمادهسازی دادهها قبل از آموزش |
| یادگیری رابطههای نامناسب | بررسی ویژگیها و آزمایش مدل با اطلاعات جدید |
| سوگیری در نتایج | ارزیابی عملکرد مدل برای گروهها و شرایط مختلف |
| تغییر شرایط واقعی | بررسی مداوم عملکرد و بهروزرسانی مدل در صورت نیاز |
| اطلاعات ساختگی | بررسی ادعاها و تطبیق با منابع معتبر |
البته هیچکدوم از این راهکارها تضمین نمیکنن که مدل هیچوقت اشتباه نکنه.
به همین دلیل، در کارهای حساس باید علاوه بر ارزیابی فنی، نظارت انسانی و روش مشخصی برای رسیدگی به خطاها داشته باشیم.
آیا هر پاسخ اشتباه یعنی مدل آموزش بدی دیده؟
نه لزوماً.
ممکنه مدل آموزش مناسبی دیده باشه، اما اطلاعات کافی برای پاسخ به یک سؤال مشخص نداشته باشه.
مثلاً اگر از مدلی که به اطلاعات امروز دسترسی نداره، قیمت فعلی یک قطعه رو بپرسیم، نمیتونیم انتظار داشته باشیم حتماً قیمت درست رو اعلام کنه.
پس باید بین محدودیت اطلاعات، ضعف آموزش و اشتباه در پردازش یا تولید پاسخ تفاوت بذاریم.
حالا که میدونیم هوش مصنوعی چطور کار میکنه و چرا ممکنه اشتباه کنه، یک سؤال کاربردی باقی میمونه:
این شناخت چه کمکی به ما میکنه؟ مثلاً یک مدیر چطور میتونه از نتیجه مدل برای تصمیمگیری استفاده کنه، بدون اینکه صرفاً به عدد پیشبینیشده اعتماد کنه؟
بیا به همون مثال شرکت تعمیراتی برگردیم.
شناخت نحوه کار هوش مصنوعی چه کاربردی در تصمیمگیری دارد؟
تا اینجا یاد گرفتیم هوش مصنوعی چطور از دادهها یاد میگیره، پیشبینی میکنه و چرا ممکنه اشتباه کنه.
اما شاید بپرسی: «من که قرار نیست مدل هوش مصنوعی بسازم، دونستن این جزئیات چه کمکی بهم میکنه؟»
بیا به مثال شرکت تعمیراتی برگردیم تا ببینیم شناخت نحوه کار هوش مصنوعی چطور میتونه روی یک تصمیم واقعی تأثیر بذاره.
۱. نتیجه هوش مصنوعی را بدون بررسی قبول نمیکنیم
فرض کن مدیر شرکت هستی و مدل پیشبینی کرده که فردا ۱۲۰ درخواست تعمیر کولر دریافت میکنی.
آیا باید دقیقاً برای ۱۲۰ درخواست، نیروی متخصص آماده کنی؟
نه لزوماً.
اول باید بدونی مدل در پیشبینیهای قبلی چقدر اشتباه کرده.
مثلاً اگر خطای معمول مدل حدود ۱۰ درخواست بوده، میفهمی که عدد ۱۲۰ یک تخمینه، نه تعداد قطعی درخواستهای فردا.
البته این هم به معنی اون نیست که تعداد واقعی حتماً بین ۱۱۰ تا ۱۳۰ خواهد بود؛ خطای پیشبینی ممکنه در بعضی روزها بیشتر باشه.
پس بهتره بهجای تصمیمگیری براساس یک عدد، میزان عدمقطعیت پیشبینی رو هم در نظر بگیری.
۲. بررسی میکنیم مدل از چه اطلاعاتی استفاده کرده
حالا فرض کن مدل برای پیشبینی درخواستهای فردا فقط از دمای هوا استفاده میکنه.
اما فردا تعطیل رسمیه و تجربه شرکت نشون میده تعداد درخواستها در تعطیلات تغییر میکنه.
اینجا میفهمی که پیشبینی مدل ممکنه یک عامل مهم رو در نظر نگرفته باشه.
پس قبل از اعتماد به نتیجه، باید بدونیم مدل از چه ورودیهایی استفاده میکنه و چه اطلاعاتی رو در اختیار نداره.
هوش مصنوعی نمیتونه از اطلاعاتی که بهش داده نشده یا رابطههایی که بهدرستی یاد نگرفته، با اطمینان نتیجه بگیره.
۳. از پیشبینی برای تصمیم بهتر استفاده میکنیم
فرض کن مدل پیشبینی کرده فردا ۱۲۰ درخواست ثبت میشه.
اما شرکت فقط ظرفیت رسیدگی به ۹۰ درخواست رو داره.
حالا این پیشبینی چه کمکی میکنه؟
مدیر میتونه بررسی کنه آیا امکان افزایش ظرفیت وجود داره، آیا لازمه زمانبندی متخصصان تغییر کنه یا باید برای درخواستهای احتمالی بیشتر برنامه جایگزین داشته باشه.
در واقع، خروجی مدل بهجای اینکه خودش تصمیم بگیره، اطلاعاتی برای تصمیمگیری بهتر در اختیار مدیر قرار میده.
البته این مثال مربوط به یک سیستم تصمیمیار هست. بعضی سیستمهای هوش مصنوعی میتونن با مجوز و کنترلهای مشخص، اقدامهای خودکار هم انجام بدن.
۴. عملکرد مدل را در طول زمان بررسی میکنیم
حالا فرض کن چند ماه از استفاده مدل گذشته.
در این مدت، شرکت وارد مناطق جدیدی شده و تعداد مشتریها افزایش پیدا کرده.
آیا باید همچنان به مدل قبلی اعتماد کنیم؟
اگر مدل با اطلاعات مربوط به شرایط گذشته آموزش دیده باشه، ممکنه دیگه پیشبینیهای دقیقی انجام نده.
برای همین، باید پیشبینیها رو با تعداد واقعی درخواستها مقایسه کنیم.
اگر خطاها بیشتر شدن، بررسی کنیم دلیلش چیه و آیا مدل به دادههای جدید یا آموزش دوباره نیاز داره.
پس برای استفاده درست از نتیجه یک مدل، چهار سؤال مهم رو باید بپرسیم:
۱. این نتیجه چقدر قابلاعتماده و مدل قبلاً چقدر خطا داشته؟
۲. مدل براساس چه اطلاعاتی به این نتیجه رسیده؟
۳. این پیشبینی قراره به چه تصمیمی کمک کنه؟
۴. آیا شرایط فعلی با شرایطی که مدل براساس اون آموزش دیده، تفاوت مهمی داره؟
این سؤالها فقط برای مدیران شرکتهای تعمیراتی نیستن.
چه بخوای از هوش مصنوعی برای پیشبینی فروش استفاده کنی، چه برای بررسی شکایت مشتریان یا تحلیل گزارشهای کسبوکار، شناخت نحوه کار مدل کمک میکنه محدودیت نتیجه رو بهتر بفهمی و تصمیم آگاهانهتری بگیری.
حالا که مسیر هوش مصنوعی رو از دریافت داده تا آموزش، ارزیابی و استفاده واقعی بررسی کردیم، میتونیم تمام این فرایند رو در چند جمله جمعبندی کنیم.
جمعبندی: هوش مصنوعی چگونه کار میکند؟
حالا اگر کسی ازت بپرسه «هوش مصنوعی چطور کار میکنه؟»، میتونی توضیح بدی که بسیاری از سیستمهای هوش مصنوعی با استفاده از دادهها آموزش میبینن تا الگوهایی رو یاد بگیرن و بعد از اونها برای پیشبینی، تشخیص یا تولید پاسخ استفاده کنن.
در این مقاله با مثال پیشبینی درخواستهای تعمیر کولر دیدیم که چطور اطلاعات آماده میشن، مدل اولین پیشبینی رو انجام میده، خطاش اندازهگیری میشه و پارامترهاش برای بهترشدن نتیجه تغییر میکنن.
همچنین فهمیدیم که همه مدلها یکسان نیستن. بعضی با رابطههای عددی کار میکنن، بعضی از درخت تصمیم استفاده میکنن و بعضی مثل شبکههای عصبی، اطلاعات رو در چندین مرحله پردازش میکنن.
اما مهمترین نکته اینه که یادگرفتن یک الگو به معنی درستبودن تمام پیشبینیهای آینده نیست. مدل باید با اطلاعات جدید آزمایش بشه و حتی بعد از شروع استفاده هم عملکردش بررسی بشه.
این شناخت فقط برای کسانی که هوش مصنوعی میسازن مفید نیست. وقتی بدونیم یک مدل چطور به نتیجه میرسه و چه محدودیتهایی داره، بهتر میتونیم ازش استفاده کنیم.
در نهایت، هوش مصنوعی میتونه در تحلیل اطلاعات و تصمیمگیری کمک بزرگی باشه؛ اما خروجی اون باید متناسب با مسئله، کیفیت دادهها و میزان خطای احتمالی بررسی بشه.
روی دکمه «مشاوره آنلاین» کلیک کنید تا مهندس ایمان پاکراه و تیم آکادمی پاکراه بهصورت آنلاین و کاملاً رایگان راهنماییتان کنند.
مشاوره آنلاین