



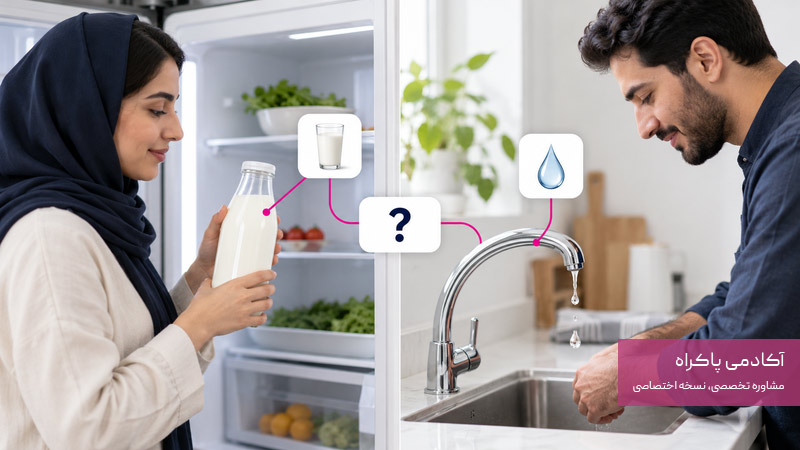
فرض کن به ChatGPT مینویسی: «شیر خراب شده، چیکار کنم؟»
این جمله بهتنهایی مشخص نمیکنه منظورت شیر آب آشپزخونهست یا شیر خوراکی که فاسد شده.
اما اگر بنویسی «شیر آب آشپزخونه چکه میکنه» یا «شیر داخل یخچال خراب شده»، موضوع روشنتر میشه.
حالا سؤال اینجاست: یک کامپیوتر چطور میتونه بفهمه یک کلمه در جملههای مختلف چه معنایی داره و پاسخی متناسب با اون تولید کنه؟
اینجاست که با مفهوم مدل زبانی بزرگ یا LLM آشنا میشیم.
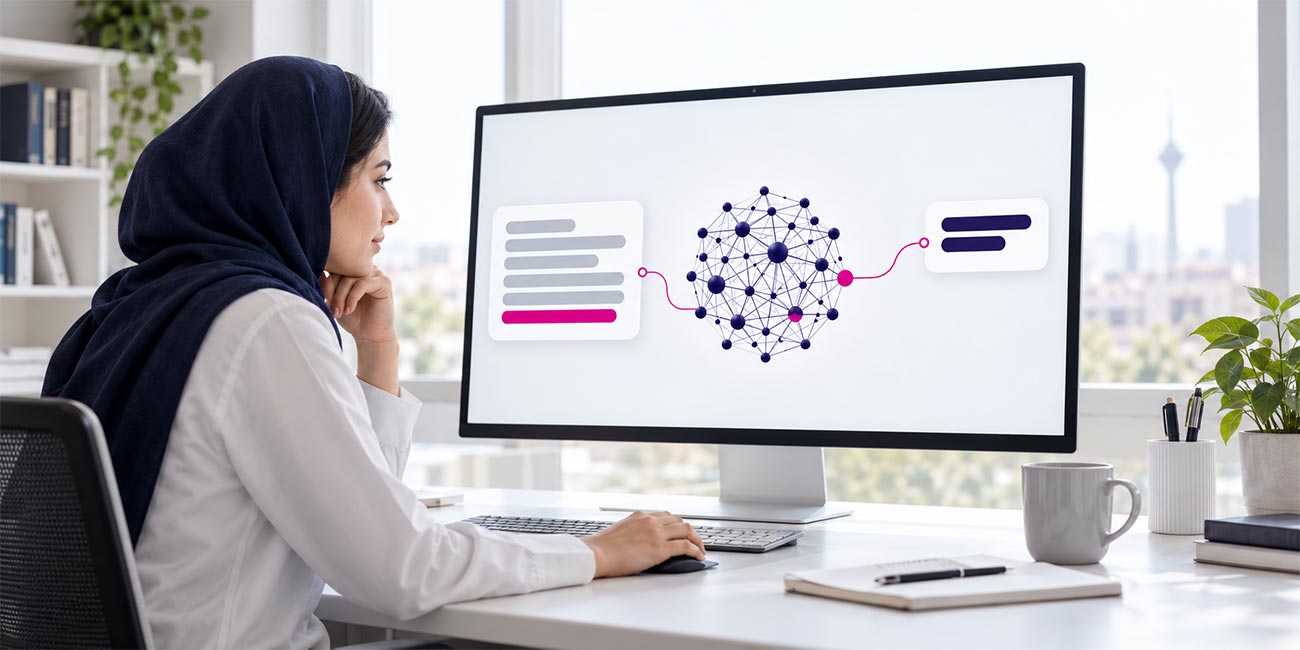
مدل زبانی بزرگ (Large Language Model) نوعی مدل هوش مصنوعیه که با یادگیری الگوها و ارتباطات موجود در دادههای زبانی، میتونه متن رو پردازش کنه، از کلمات اطراف و زمینه گفتوگو برای تشخیص منظور احتمالی استفاده کنه و پاسخ تولید کنه.
اما این مدل چطور زبان ما رو یاد میگیره و اصلاً چرا بهش میگن «مدل زبانی بزرگ»؟ برای پاسخ به این سوال، تا انتهای این مطلب از آکادمی پاکراه همراه باشید!
مدل زبانی بزرگ چیست و LLM مخفف چه عبارتی است؟
LLM مخفف عبارت انگلیسی Large Language Model به معنی «مدل زبانی بزرگ» است.
برای اینکه مفهومش رو درست بفهمیم، بهتره این سه کلمه رو جداگانه بررسی کنیم.
مدل (Model) یعنی چه؟
فرض کن به یک کودک چند تصویر از سیب و پرتقال نشون میدی و اسم هرکدوم رو بهش میگی. کودک بهمرور تفاوت اونها رو یاد میگیره و بعداً میتونه میوهای رو که قبلاً ندیده هم تشخیص بده.
در هوش مصنوعی هم میشه سیستمی رو با نمونههای مختلف آموزش داد تا الگوها رو یاد بگیره و از آموختههاش برای بررسی اطلاعات جدید استفاده کنه.
به چنین ساختار آموزشدیدهای در یادگیری ماشین، مدل میگیم.
زبانی (Language) یعنی چه؟
برگردیم به همون مثال «شیر خراب شده».
اگر بگی «شیر داخل یخچال خراب شده»، احتمالاً منظورت شیر خوراکیه. اما وقتی میگی «شیر آب آشپزخونه خراب شده»، درباره وسیلهای صحبت میکنی که جریان آب رو کنترل میکنه.
کلمه «شیر» در هر دو جمله یکسانه، ولی معنی اون با توجه به کلمات اطرافش تغییر میکنه.
مدل زبانی با یادگیری الگوها و ارتباط بین کلمات و جملهها میتونه این تفاوتها رو تشخیص بده و پاسخ متناسبی تولید کنه.
پس منظور از زبان در LLM، زبان انسان مثل فارسی و انگلیسیه، نه زبان صفر و یک کامپیوتر. البته مدلهای زبانی میتونن با زبانهای برنامهنویسی هم کار کنن.
کامپیوتر برای پردازش این زبانها، اطلاعات رو به شکل عددی نمایش میده؛ موضوعی که در بخش نحوه کار مدل توضیح میدیم.
بزرگ (Large) یعنی چه؟
فرض کن بخوای زبان فارسی رو فقط با خوندن ده جمله یاد بگیری. با این تعداد جمله نمیتونی معنی هزاران کلمه و کاربرد اونها رو در موقعیتهای مختلف بشناسی.
مدلهای زبانی بزرگ هم معمولاً با مجموعه گستردهای از نوشتهها، مثل کتابها، مقالهها، صفحات وب و کدهای برنامهنویسی آموزش میبینن.
این مدلها تعداد زیادی پارامتر هم دارن.
پارامترها مقادیر عددی درون مدل هستن که هنگام آموزش تنظیم میشن و به مدل کمک میکنن الگوهای آموختهشده رو در پردازش اطلاعات به کار بگیره.
بنابراین کلمه «بزرگ» به مقیاس مدل، بهویژه تعداد زیاد پارامترهاش، اشاره میکنه؛ نه اینکه حتماً پاسخهای طولانی تولید کنه.
مدل زبانی بزرگ یک بانک اطلاعاتی از پاسخهای آماده نیست. این مدل الگوهای زبان رو یاد میگیره و میتونه براساس درخواست ما متن جدیدی تولید کنه؛ حتی متنی که دقیقاً به همون شکل در دادههای آموزشی وجود نداشته.
حالا که مفهوم مدل زبانی بزرگ رو شناختیم، بیایم ببینیم وقتی یک جمله فارسی براش مینویسیم، چطور اون رو پردازش میکنه و به ما پاسخ میده.
مدل زبانی بزرگ (LLM) چگونه کار میکند؟
برای اینکه بفهمیم مدل زبانی چطور کار میکنه، بیایم مسیر یک پیام رو از زمانی که مینویسیم تا وقتی پاسخ میگیریم، دنبال کنیم.
فرض کن به ChatGPT مینویسی:
«شیر آب آشپزخونه خراب شده، چیکار کنم؟»
تو این جمله رو به زبان فارسی مینویسی و معنی کلماتش رو میفهمی. اما کامپیوتر مثل انسان کلمات رو نمیخونه؛ برای پردازش اونها از محاسبات عددی استفاده میکنه.
پس متن باید به شکلی تبدیل بشه که مدل بتونه باهاش کار کنه.
۱. توکن چیست و متن چطور به توکن تبدیل میشود؟
اول متن به بخشهای کوچکتری به نام توکن (Token) تقسیم میشه.
توکن ممکنه یک کلمه کامل، بخشی از یک کلمه یا یک علامت نگارشی باشه.
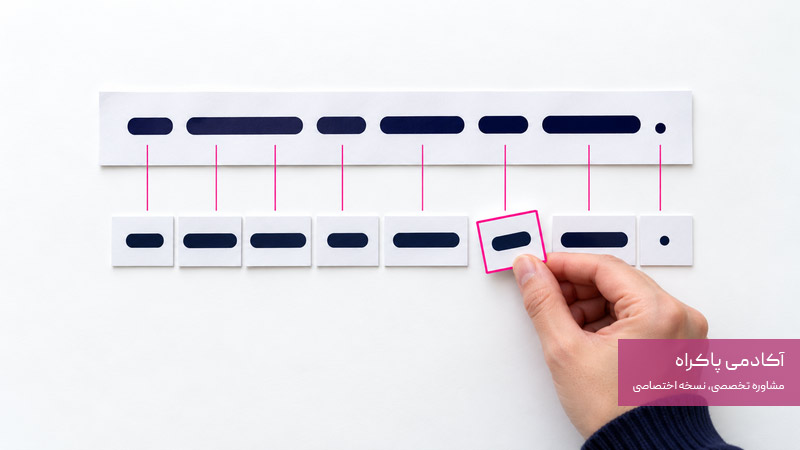
جمله «شیر آب آشپزخونه خراب شده، چیکار کنم؟» رو در نظر بگیر.
برای اینکه مفهوم توکن رو بفهمیم، فرض کن متن به این بخشها تقسیم بشه:
«شیر» | «آب» | «آشپز» | «خونه» | «خراب» | «شده» | «،» | «چی» | «کار» | «کنم» | «؟»
هرکدوم از این بخشها یک شناسه عددی دریافت میکنن. مثلاً ممکنه برای آموزش، «شیر» رو با عدد ۱۰۲ و «آب» رو با عدد ۵۸۴ نمایش بدیم.
این شمارهها فرضی هستن و مدلهای مختلف ممکنه همین جمله رو به توکنهای متفاوتی تقسیم کنن.
حالا مدل بهجای اینکه مستقیماً با شکل نوشتاری کلمات کار کنه، شناسههای عددی توکنها رو دریافت میکنه و اونها رو به نمایشهای عددی مناسب برای محاسبات تبدیل میکنه.
۲. مدل چطور ارتباط بین کلمات را تشخیص میدهد؟
اینجا فقط عدد هر توکن مهم نیست؛ ارتباط بخشهای مختلف جمله با هم هم اهمیت داره.
در مثال ما، کلمه «شیر» بهتنهایی میتونه چند معنی داشته باشه.
اما وقتی کنار «آب» و «آشپزخونه» قرار میگیره، مدل با توجه به الگوهایی که یاد گرفته، تشخیص میده احتمالاً درباره شیر آب صحبت میکنیم، نه شیر خوراکی.
پس مدل صرفاً کلمات رو جداگانه بررسی نمیکنه؛ از کلمات اطراف و زمینه گفتوگو هم برای پردازش پیام کمک میگیره.
۳. مدل زبانی این ارتباطها را چطور یاد گرفته است؟
قبل از اینکه با یک مدل زبانی گفتوگو کنیم، اون رو با حجم زیادی از دادههای زبانی، مثل کتابها، مقالهها، صفحات وب و کدهای برنامهنویسی آموزش میدن.
یکی از روشهای رایج آموزش اینه که مدل بخشی از متن رو ببینه و تلاش کنه توکن بعدی رو پیشبینی کنه. سپس براساس خطای پیشبینی، مقادیر عددی درون مدل که به اونها «پارامتر» میگیم، تنظیم میشن.
این فرایند بارها تکرار میشه تا مدل بتونه الگوها و روابط پیچیده زبان رو یاد بگیره.
بنابراین مدل برای پاسخدادن به هر سؤال، لازم نیست از ابتدا آموزش ببینه. هنگام گفتوگو از تواناییهایی که قبلاً آموخته استفاده میکنه.
۴. مدل چطور پاسخ تولید میکند؟
بعد از پردازش پیام، مدل با توجه به درخواست تو و زمینه گفتوگو، توکنهای پاسخ رو یکی پس از دیگری تولید میکنه.
سپس این توکنها به متنی تبدیل میشن که روی صفحه میبینی.
برای سؤال «شیر آب آشپزخونه خراب شده، چیکار کنم؟» ممکنه مدل پاسخ بده:
«شیر آب چکه میکنه یا دستهاش خراب شده؟ اگه نوع مشکل رو بگی، بهتر میتونم راهنماییات کنم.»
مدل با بررسی ارتباط کلمات متوجه موضوع احتمالی شده و چون نوع خرابی مشخص نیست، سؤال دقیقتری پرسیده.
آیا مدل زبانی تمام جوابها را از قبل حفظ کرده است؟
نه. مدل زبانی یک بانک پاسخ آماده نیست. در فرایند آموزش، الگوها و روابط زیادی رو یاد میگیره و هنگام دریافت درخواست، با استفاده از اونها پاسخ تولید میکنه.
البته این به معنی درستبودن همه پاسخها نیست؛ مدل ممکنه اطلاعات اشتباه یا ساختگی هم ارائه بده.
پس مسیر کار مدل زبانی رو میتونیم خیلی ساده اینطور خلاصه کنیم:
متن ورودی ← تبدیل به توکن ← پردازش عددی و بررسی ارتباطها ← تولید توکنهای پاسخ ← نمایش متن به کاربر
این فرایند توضیح میده که یک مدل زبانی چطور میتونه با زبان ما کار کنه؛ حتی اگر خودش زبان رو به شیوه انسان تجربه نکنه.
مدل زبانی بزرگ چه تفاوتی با ChatGPT دارد؟
تا اینجا فهمیدیم مدل زبانی بزرگ چطور متن رو پردازش میکنه و پاسخ میسازه.
اما یک سؤال مهم وجود داره:
آیا ChatGPT خودش یک مدل زبانی بزرگه؟
نه دقیقاً. ChatGPT یک محصول هوش مصنوعیه که از مدلهای زبانی و قابلیتهای دیگه برای گفتوگو و انجام درخواستهای کاربران استفاده میکنه.
برای درک تفاوت، یک خودرو رو تصور کن.
موتور یکی از اجزای اصلی خودروئه، اما خودرو فقط موتور نیست؛ فرمان، ترمز، چرخ و بخشهای دیگهای هم داره که با هم کار میکنن.
مدل زبانی رو هم میتونیم به موتور پردازش زبان تشبیه کنیم. ChatGPT محصولیه که از این مدل در کنار امکانات دیگه استفاده میکنه.
مثلاً وقتی از ChatGPT میخوای متنی بنویسه، مدل زبانی در تولید پاسخ نقش اصلی داره. اما وقتی ازش میخوای اطلاعات جدیدی رو در اینترنت جستوجو کنه، محصول باید به ابزار جستوجو هم دسترسی داشته باشه.
آیا همه مدلهای زبانی بزرگ متعلق به ChatGPT هستند؟
نه. شرکتها و مجموعههای پژوهشی مختلف، خانوادههای متفاوتی از مدلهای زبانی رو توسعه دادن.
برای مثال:
- GPT: خانوادهای از مدلهای توسعهیافته توسط OpenAI.
- Claude: خانواده مدلهای هوش مصنوعی شرکت Anthropic.
- Gemini: خانواده مدلهای هوش مصنوعی گوگل.
- Llama: خانواده مدلهای توسعهیافته توسط Meta.
بعضی از این خانوادهها مدلهای چندوجهی هم دارن؛ یعنی علاوه بر متن، میتونن اطلاعاتی مثل تصویر یا صدا رو پردازش کنن.
مدل زبانی بزرگ فقط مخصوص چتباتها نیست.
یک شرکت میتونه از مدل زبانی در سامانه پشتیبانی مشتری، یک خودرو برای فهم دستورهای صوتی راننده، یک نرمافزار پزشکی برای خلاصهکردن گزارشها یا یک ربات برای پردازش دستورهای زبانی استفاده کنه.
البته این به معنی اون نیست که تمام هوش مصنوعیهای خودرو، پزشکی یا رباتیک از LLM استفاده میکنن. مدل زبانی فقط میتونه یکی از اجزای چنین سیستمهایی باشه.
پس LLM یک فناوری برای پردازش و تولید زبان است، اما ChatGPT یکی از محصولاتی است که از این فناوری استفاده میکند.
مدلهای زبانی بزرگ (LLM) چه کاربردهایی دارند؟
حالا که فهمیدیم مدل زبانی بزرگ فقط مخصوص ChatGPT و چتباتها نیست، بیایم ببینیم در عمل چه کارهایی میتونه انجام بده.
هر جایی که لازم باشه یک سیستم هوشمند زبان رو پردازش کنه یا متن تولید کنه، ممکنه از LLM استفاده بشه. البته بسته به نوع فعالیت، گاهی به فناوریهای دیگه هم نیاز داره.
کاربرد LLM در زندگی روزمره و کسبوکارها
| حوزه | کاربرد مدل زبانی بزرگ | مثال ساده |
|---|---|---|
| پشتیبانی مشتریان | بررسی پیامها و تولید پاسخ | پاسخدادن به سؤال مشتری درباره وضعیت سفارش |
| تولید محتوا | نوشتن و ویرایش متن | تهیه پیشنویس مقاله یا متن تبلیغاتی |
| آموزش | توضیح مفاهیم و پاسخ به سؤالها | توضیح یک مسئله ریاضی به زبان ساده |
| ترجمه | پردازش و ترجمه زبانها | ترجمه یک ایمیل انگلیسی به فارسی |
| برنامهنویسی | تولید و توضیح کد | پیداکردن خطای احتمالی در یک قطعه کد |
| پزشکی | پردازش متن گزارشها و اسناد | خلاصهکردن سوابق پزشکی برای بررسی متخصص |
| خودروهای هوشمند | پردازش دستورهای زبانی راننده | پاسخ به سؤال راننده درباره امکانات خودرو |
| رباتیک | فهم دستورهای متنی و کمک به برنامهریزی | تبدیل درخواست «وسایل روی میز رو مرتب کن» به مراحل انجام کار |
آیا LLM میتواند صدا، تصویر یا ویدئو را هم پردازش کند؟
بعضی مدلهای زبانی پیشرفته علاوه بر متن، قابلیت پردازش اطلاعاتی مثل صدا و تصویر رو هم دارن. به مدلهایی که با چند نوع داده کار میکنن، مدل چندوجهی (Multimodal) میگیم.
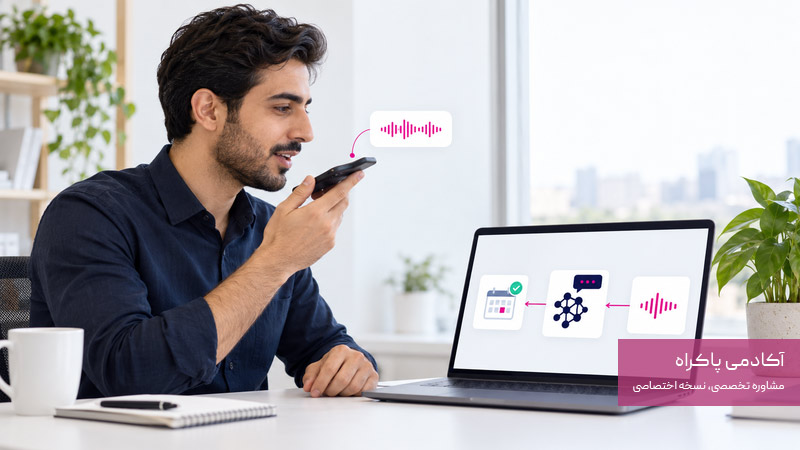
فرض کن با یک دستیار صوتی صحبت میکنی و میگی: «برای فردا ساعت ۸ صبح یه یادآوری تنظیم کن.»
در یک سیستم ممکنه ابتدا مدل تشخیص گفتار، صدای تو رو به متن تبدیل کنه. بعد مدل زبانی درخواست رو پردازش کنه و یک ابزار تقویم یا یادآوری، در صورت داشتن دسترسی لازم، اون رو ثبت کنه.
در بعضی سیستمهای دیگه، مدل چندوجهی میتونه مستقیماً ورودی صوتی رو پردازش کنه.
همین موضوع درباره تولید تصویر و ویدئو هم صدق میکنه. یک مدل زبانی ممکنه دستور متنی کاربر رو پردازش کنه، اما ساخت خود تصویر یا ویدئو میتونه توسط مدل مولد تخصصی دیگری انجام بشه.
پس LLM میتونه در بخشهای مختلف یک سیستم هوش مصنوعی نقش داشته باشه، اما قرار نیست تمام وظایف اون سیستم رو بهتنهایی انجام بده.
آیا مدلهای زبانی بزرگ از فارسی هم پشتیبانی میکنند؟
بله. بسیاری از مدلهای زبانی بزرگ میتونن متن فارسی رو پردازش کنن، به سؤالهای فارسی پاسخ بدن و حتی ترجمه یا تولید محتوای فارسی انجام بدن.
اما کیفیت عملکردشون یکسان نیست. ممکنه یک مدل در زبان انگلیسی پاسخ دقیقتری بده، ولی در تشخیص اصطلاحات محاورهای، ضربالمثلها یا جزئیات فرهنگی فارسی اشتباه کنه.
بنابراین پشتیبانی از زبان فارسی الزاماً به معنی درک درست تمام اصطلاحات و تولید پاسخ بدون خطا نیست.
مدلهای زبانی بزرگ چه محدودیتهایی دارند؟
مدلهای زبانی بزرگ میتونن متنهای روان و قابلفهم تولید کنن، اما پاسخ روان همیشه به معنی پاسخ درست نیست.
این مدلها ممکنه اشتباه کنن، اطلاعات ناقص داشته باشن یا منظور ما رو درست تشخیص ندن.
برای اینکه بدونیم چه زمانی میشه به پاسخ یک LLM اعتماد کرد، باید محدودیتهای اصلی اون رو بشناسیم.
۱. ممکن است اطلاعات اشتباه تولید کنند
فرض کن از یک مدل زبانی میخوای نام نویسنده و سال انتشار یک کتاب رو بهت بگه.
ممکنه مدل نام نویسنده یا تاریخی رو با اطمینان اعلام کنه که اصلاً درست نیست.
به این اتفاق توهم هوش مصنوعی (AI Hallucination) میگن؛ یعنی مدل اطلاعاتی تولید میکنه که واقعی یا قابلتأیید نیست، اما ممکنه کاملاً درست به نظر برسه.
۲. ممکن است اطلاعات جدید را ندانند
مدل زبانی هنگام آموزش از دادههای مشخصی استفاده میکنه. بنابراین ممکنه از اتفاقاتی که بعد از دوره آموزش رخ دادن، اطلاع نداشته باشه.
البته بعضی ابزارهای مجهز به LLM میتونن به اینترنت یا پایگاههای اطلاعاتی متصل بشن و اطلاعات جدیدتری به دست بیارن.
پس باید بین دانستههای آموختهشده مدل و اطلاعاتی که از ابزارهای متصل دریافت میکنه تفاوت بذاریم.
۳. ممکن است منظور کاربر را اشتباه متوجه شوند
یادت هست در ابتدای مقاله گفتیم: «شیر خراب شده، چیکار کنم؟»
اگر مشخص نکنی منظورت شیر آب یا شیر خوراکیه، مدل ممکنه یکی از معنیها رو انتخاب کنه و پاسخ نامناسبی بده.
حتی وقتی سؤال روشنه، باز هم احتمال برداشت اشتباه وجود داره. بنابراین گاهی بهتره مدل بهجای حدسزدن، از کاربر سؤال دقیقتری بپرسه.
۴. ممکن است پاسخهای سوگیرانه تولید کنند
مدلهای زبانی از دادههایی آموزش میبینن که ممکنه در اونها دیدگاههای یکطرفه، کلیشهها یا اطلاعات نادرست وجود داشته باشه.
در نتیجه، ممکنه بعضی پاسخها هم تحت تأثیر این الگوها قرار بگیرن.
همچنین کیفیت عملکرد مدل در زبانها و موضوعات مختلف لزوماً یکسان نیست.
۵. استفاده از آنها همیشه بدون خطر نیست
وقتی اطلاعات شخصی مشتریان، اسناد محرمانه شرکت یا اطلاعات پزشکی رو در اختیار یک ابزار هوش مصنوعی میذاریم، باید به نحوه پردازش و نگهداری اون اطلاعات توجه کنیم.
برای مثال، نباید بدون بررسی تنظیمات حریم خصوصی و مجوزهای لازم، اطلاعات محرمانه مشتریان رو وارد هر ابزار مبتنی بر LLM کنیم.
چطور از مدلهای زبانی بهتر استفاده کنیم؟
درخواستت رو روشن و با جزئیات لازم بنویس، برای اطلاعات مهم منبع معتبر بخواه و قبل از استفاده از پاسخ در تصمیمهای حساس، درستی اون رو بررسی کن.
بهتره LLM رو یک ابزار قدرتمند برای کمک به انجام کارها بدونیم، نه مرجعی که همیشه پاسخ درست میده.
جمعبندی: مدل زبانی بزرگ (LLM) چیست؟
مدل زبانی بزرگ یا LLM نوعی مدل هوش مصنوعیه که با یادگیری الگوها و ارتباطات زبان، میتونه متن رو پردازش کنه، به سؤالها پاسخ بده و محتوای جدید تولید کنه.
این مدلها فقط مخصوص ChatGPT و چتباتها نیستن و میتونن در نرمافزارهای آموزشی، پشتیبانی مشتریان، دستیارهای صوتی، پزشکی و سیستمهای هوشمند دیگه هم استفاده بشن.
نکته مهم اینه که LLM تمام اطلاعات رو بهصورت پاسخهای آماده ذخیره نمیکنه. بلکه از الگوهایی که هنگام آموزش یاد گرفته، برای پردازش درخواست و تولید پاسخ استفاده میکنه.
البته مدلهای زبانی هم محدودیت دارن و ممکنه اشتباه کنن. بنابراین هرچقدر هم پاسخ اونها طبیعی و قانعکننده باشه، برای اطلاعات و تصمیمهای مهم باید درستی خروجی رو بررسی کنیم.
روی دکمه «مشاوره آنلاین» کلیک کنید تا مهندس ایمان پاکراه و تیم آکادمی پاکراه بهصورت آنلاین و کاملاً رایگان راهنماییتان کنند.
مشاوره آنلاین