


توهم هوش مصنوعی (AI Hallucination) یعنی هوش مصنوعی اطلاعات نادرست یا ساختگی تولید کنه و اونها رو طوری بیان کنه که انگار واقعیت دارن. این اتفاق لزوماً به معنی دروغگویی عمدی نیست، اما نشون میده که پاسخهای هوش مصنوعی همیشه قابل اعتماد نیستن.
در پژوهشی که OpenAI سال ۲۰۲۵ منتشر کرد، از یک چتبات درباره عنوان رساله دکتری یکی از پژوهشگران سؤال پرسیدن. چتبات سه پاسخ متفاوت داد و هر سه اشتباه بودن.
حالا تصور کن چنین اطلاعاتی وارد یک مقاله آموزشی، گزارش کسبوکاری یا تصمیم مهم زندگی بشه و دیگران هم براساس اون یاد بگیرن یا تصمیم بگیرن.
در ادامه این مطلب از آکادمی پاکراه، میخوام توضیح بدم چرا چنین اتفاقی میافته، چطور میتونیم اطلاعات ساختگی رو تشخیص بدیم و چه نظارتی لازمه تا احتمال آسیب کمتر بشه.
- توهم هوش مصنوعی چیست؟
- توهم هوش مصنوعی چه شکلهایی دارد؟
- علت توهم هوش مصنوعی چیست؟
- توهم هوش مصنوعی بیشتر در چه مواقعی رخ میدهد؟
- آیا هوش مصنوعی قابل اعتماد است؟
- توهم هوش مصنوعی چه پیامدهایی دارد؟
- توهم هوش مصنوعی چه تأثیری بر یادگیری و آینده دانش انسانها دارد؟
- چطور توهم هوش مصنوعی را تشخیص دهیم؟
- چطور احتمال توهم هوش مصنوعی را کاهش دهیم؟
- جمعبندی
توهم هوش مصنوعی چیست؟
وقتی میگیم هوش مصنوعی دچار توهم شده، منظورمون اینه که اطلاعاتی تولید کرده که با واقعیت یا منابع مبنا مطابقت ندارن.
توهم انسان و هوش مصنوعی چه تفاوتی دارند؟
برای درک این اصطلاح، ابتدا باید معنای توهم در انسان رو بشناسیم.
در روانشناسی، توهم (Hallucination) تجربه ادراکی بدون محرک خارجی متناظره؛ مثلاً فرد صدایی رو میشنوه که منبع خارجی نداره. این تجربه هم لزوماً به معنی ابتلا به یک اختلال روانی مشخص نیست.
چند مفهوم نزدیک به توهم وجود دارن:
| مفهوم | تعریف ساده |
|---|---|
| توهم (Hallucination) | تجربه ادراکی بدون محرک خارجی متناظر |
| خطای ادراکی (Illusion) | برداشت اشتباه از چیزی که واقعاً وجود داره |
| هذیان (Delusion) | باور نادرستی که باوجود شواهد مخالف، بهشدت حفظ میشه |
| کانفابولیشن (Confabulation) | بازسازی خاطره یا روایت نادرست، بدون قصد آگاهانه برای فریب |
کانفابولیشن رو میتونیم «خاطرهسازی ناخواسته» بنامیم.
مثلاً فردی بهدلیل اختلال حافظه، اتفاقی رو با اطمینان تعریف میکنه که واقعاً رخ نداده، اما قصد دروغگفتن هم نداره.
در مقالهای که سال ۲۰۲۳ در مجله PLOS Digital Health منتشر شد، پژوهشگران پیشنهاد کردن کانفابولیشن میتونه استعاره مناسبتری برای خطاهای مدلهای زبانی باشه؛ چون مدلها اطلاعات ساختگی تولید میکنن، نه اینکه مانند انسان تجربه حسی داشته باشن.
البته این یک پیشنهاد پژوهشیه، نه اینکه همه دانشمندان بر سر جایگزینی این اصطلاح توافق داشته باشن.
فرهنگ لغت کمبریج هم در سال ۲۰۲۳ واژه Hallucinate رو بهعنوان کلمه سال انتخاب کرد و معنای مربوط به تولید اطلاعات نادرست توسط AI رو به اون افزود.
پس توهم هوش مصنوعی یک اصطلاح استعاریه و نباید اون رو با تجربه روانشناختی انسان یکسان بدونیم.
آیا هوش مصنوعی راست میگوید یا دروغ؟
در دروغگویی عمدی انسان، فرد حقیقت رو میدونه و آگاهانه خلاف اون رو بیان میکنه.
اما مدل زبانی برای تولید پاسخ از سازوکاری متفاوت با باور و قصد انسانی استفاده میکنه. بنابراین نباید اطلاعات ساختگی اون رو لزوماً مثل دروغگویی عمدی یک انسان تفسیر کنیم.
بعضی پژوهشگران فلسفه فناوری هم اصطلاح «توهم» رو نقد میکنن؛ چون ممکنه این تصور رو ایجاد کنه که مدل مثل انسان تلاش میکنه حقیقت رو تشخیص بده.
پاسخ کوتاه اینه: هوش مصنوعی میتونه اطلاعات غلط تولید کنه، اما تولید این اطلاعات بهخودیخود نشونه قصد آگاهانه برای فریب نیست.
توهم هوش مصنوعی چه شکلهایی دارد؟
گاهی تمام پاسخ اشتباهه و گاهی بیشتر اطلاعات درسته، اما مدل یک عدد، نام یا نتیجه ساختگی به اون اضافه میکنه.
شش شکل کاربردی توهم رو ببینیم:
| شکل توهم | مثال |
|---|---|
| آمار ساختگی | اعلام درصد دقیق تعطیلی رستورانهای یک شهر، بدون آمار معتبر |
| منبع و لینک ساختگی | معرفی مقاله دانشگاهی با عنوان و نویسندهای که وجود ندارن |
| نقلقول یا رویداد غیرواقعی | نسبتدادن جملهای به یک شخصیت تاریخی که هرگز اون رو نگفته |
| اطلاعات نادرست درباره اشخاص و محصولات | معرفی قابلیتی برای دستگاه تصفیه آب که در مشخصات واقعی اون وجود نداره |
| اضافهکردن اطلاعات به فایل | تبدیل یک پیشنهاد مطرحشده در صورتجلسه به تصمیم تصویبشده |
| ادعای انجام کاری که انجام نشده | گفتن «سایت رو بررسی کردم»، درحالیکه مدل صفحه رو باز نکرده |
دو مورد آخر به توضیح بیشتری نیاز دارن.
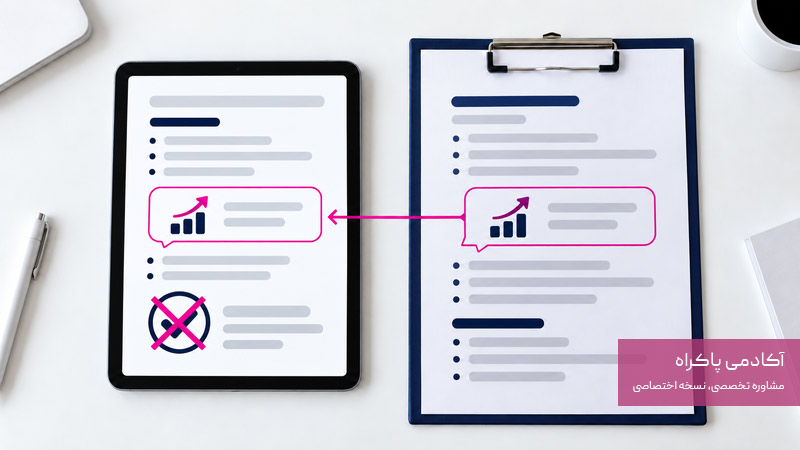
وقتی هوش مصنوعی اطلاعاتی به فایل اضافه میکند
فرض کن صورتجلسه شرکت رو بارگذاری میکنی و میخوای تصمیمهای جلسه رو استخراج کنه.
مدل مینویسه:
«تصویب شد بودجه تبلیغات سال آینده ۲۰ درصد افزایش پیدا کنه.»
اما در صورتجلسه فقط پیشنهاد افزایش بودجه مطرح شده و هیچ تصمیمی تصویب نشده.
اینجا بحث درباره یک موضوع بهاشتباه به تصمیم قطعی تبدیل شده؛ یعنی مدل نتیجهای رو به فایل نسبت داده که در اون وجود نداره.
وقتی هوش مصنوعی ادعا میکند کاری را انجام داده
ممکنه از مدل بخوای مشخصات یک وبسایت رو بررسی کنه و پاسخ بده «سایت رو بررسی کردم»، درحالیکه به صفحه موردنظر دسترسی نداشته.
پس علاوه بر اطلاعاتی که مدل ارائه میده، ادعای اون درباره ابزارها و کارهایی که انجام داده هم باید قابلبررسی باشه.
آیا هر پاسخ اشتباه، توهم هوش مصنوعی است؟
خیر. همه خطاها لزوماً توهم نیستن.
| نوع خطا | مثال | تفاوت |
|---|---|---|
| اطلاعات قدیمی | اعلام قیمت سال گذشته یک محصول | اطلاعات ممکنه قبلاً درست بوده باشن |
| خطای محاسباتی | اشتباه در جمع هزینههای فاکتور | ممکنه صرفاً خطای محاسبه باشه |
| سوءبرداشت از سؤال | پاسخ درباره فروش حضوری بهجای فروش اینترنتی | مدل منظور سؤال رو درست نفهمیده |
| توهم | اعلام قانونی که اصلاً وجود نداره | اطلاعات ساختگی بهعنوان واقعیت مطرح شده |
البته مرز این خطاها در همه پژوهشها یکسان نیست. بعضی مطالعات تعریف گستردهتری از توهم دارن و انواع دیگری از خطا رو هم شامل میشن.
علت توهم هوش مصنوعی چیست؟
چرا هوش مصنوعی با وجود آموزشدیدن روی اطلاعات فراوان، گاهی جواب اشتباه میده؟ چرا چت جی پی تی و سایر مدلهای زبانی ممکنه اطلاعاتی بسازن که وجود ندارن؟
برای پاسخ باید پنج عامل مهم رو بشناسیم.
۱. تولید پاسخ براساس الگوهای آموختهشده
مدلهای زبانی الگوها و ارتباطات موجود در دادهها رو یاد میگیرن و از اونها برای تولید پاسخ استفاده میکنن.
مثلاً اگر درباره رفع یک خطای ناشناخته در نرمافزار حسابداری سؤال بپرسی، ممکنه مراحلی رو پیشنهاد بدن که شبیه تنظیمات نرمافزارهای دیگه هستن، اما در نرمافزار تو وجود ندارن.
بنابراین تولید یک راهنمای منطقی، به معنی آزمایششدن مراحل اون در نرمافزار واقعی نیست.
۲. تشویق به حدسزدن در بعضی روشهای آموزش
OpenAI در پژوهش سال ۲۰۲۵ توضیح داد که بعضی روشهای ارزیابی مدلها، پاسخدادن رو بیشتر از اعلام ندانستن تشویق میکنن.
یک آزمون تستی بدون نمره منفی رو تصور کن. اگر جواب رو ندونی، حدسزدن ممکنه امتیاز داشته باشه، اما خالیگذاشتن سؤال امتیازی نداره.
در بعضی روشهای ارزیابی هوش مصنوعی هم این منطق میتونه پاسخهای حدسی رو تقویت کنه.
البته مدل مثل انسان آگاهانه تصمیم نمیگیره که ریسک کنه؛ این تشبیهی برای توضیح اثر روشهای ارزیابیه.
مدلی که کمتر میگه «نمیدونم»، لزوماً قابلاعتمادتر نیست.
۳. نداشتن اطلاعات کافی یا معتبر
هوش مصنوعی همیشه به اطلاعات اختصاصی شرکتها، جزئیات محصولات یا تغییرات جدید دسترسی نداره. دادههای آموزشی اون هم ممکنه ناقص، متناقض یا نادرست باشن.
مثلاً مشتری از یک چتبات میپرسه تعمیر یخچالش چقدر هزینه داره.
اگر چتبات بدون اطلاع از برند، مدل، علت خرابی و هزینه قطعات، مبلغ قطعی بسازه، ممکنه با توهم روبهرو باشیم.
گاهی پاسخ درست اینه که ابزار اطلاعات بیشتری بخواد یا اعلام کنه هنوز نمیتونه پاسخ قطعی بده.
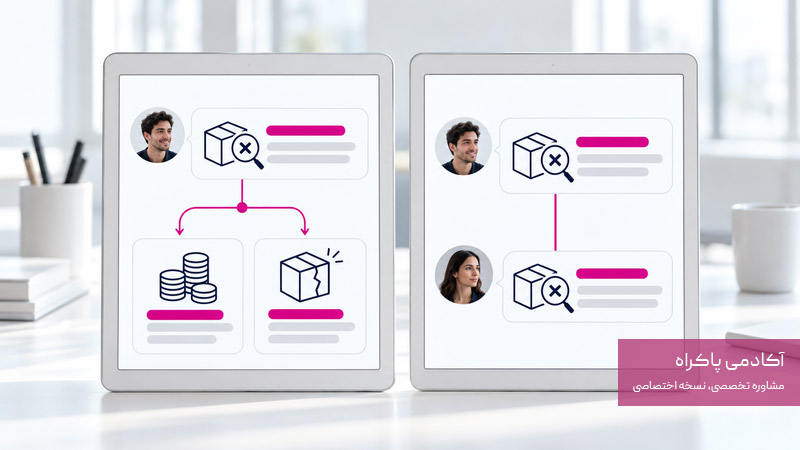
۴. تمایل مدل به تأیید کاربر و تأثیر سؤالهای جهتدار
بعضی مدلها بیشازحد با نظر کاربر موافقت میکنن. به این رفتار چاپلوسی هوش مصنوعی (Sycophancy) گفته میشه.
فرض کن مدیر شرکتی بگه:
«برای کاهش هزینهها تصمیم گرفتم بخش کنترل کیفیت رو حذف کنم. این تصمیم منطقیه، درسته؟»
مدل ممکنه بهجای بررسی خطرات تصمیم، بیشتر روی مزایای کاهش هزینه تمرکز کنه.
پژوهش Anthropic در سال ۲۰۲۳ نشون داد که بعضی مدلهای آموزشدیده با بازخورد انسانی، در شرایطی پاسخهای هماهنگ با باور کاربر رو ترجیح میدن.
OpenAI هم در آوریل ۲۰۲۵ یکی از بهروزرسانیهای ChatGPT رو بهدلیل موافقت و تأیید بیشازحد کاربران برگردوند.
البته دو موضوع متفاوت داریم:
- چاپلوسی: رفتاری که ممکنه در اثر نحوه آموزش و تنظیم مدل ایجاد بشه.
- سؤال جهتدار: درخواستی که از ابتدا یک نتیجه رو درست فرض میکنه و مدل رو به سمت تأیید اون هدایت میکنه.
مثلاً بهجای «چرا افتتاح شعبه جدید رستورانم بهترین تصمیمه؟» بهتره بپرسی «برای افتتاح شعبه جدید چه فرصتها، هزینهها و خطراتی رو باید بررسی کنم؟»
پژوهش Giskard در سال ۲۰۲۵ هم نشون داد که در بعضی شرایط آزمایششده، ادعاهای نادرستِ مطرحشده با لحنی بسیار مطمئن، توانایی مدلها رو برای مخالفت کاهش میدن.
چاپلوسی بهتنهایی توهم نیست؛ اما اگر مدل برای تأیید کاربر دلیل یا اطلاعات ساختگی تولید کنه، این دو مشکل همزمان اتفاق میافتن.
این شواهد نشون میدن آموزش مدل برای جلب رضایت کاربر ممکنه پیامدهای ناخواسته داشته باشه؛ ولی بهتنهایی اثبات نمیکنن که سازندگان عمداً قصد گمراهکردن کاربران رو دارن.
۵. تفسیر اشتباه منابع و اطلاعات اینترنتی
دسترسی به اینترنت میتونه به مدل در یافتن اطلاعات کمک کنه، اما تضمین نمیکنه اون اطلاعات رو درست تفسیر کنه.
مثلاً ممکنه یک صفحه واقعی درباره ثبت شرکت پیدا کنه، اما مدرکی رو به فهرست الزامات قانونی اضافه کنه که در منبع وجود نداره.
پس باید بین پیداکردن یک منبع و درست استفادهکردن از اطلاعات اون تفاوت بذاریم.
توهم هوش مصنوعی بیشتر در چه مواقعی رخ میدهد؟
برای همه موضوعات نمیشه یک احتمال ثابت تعیین کرد؛ اما بعضی موقعیتها بهدلیل نیاز به اطلاعات دقیق، جدید یا اختصاصی، بررسی بیشتری میخوان.
| موقعیت | چه چیزی را بررسی کنیم؟ |
|---|---|
| آمار و اعداد دقیق | منبع، سال و جامعه آماری |
| مقالات علمی و نقلقولها | وجود واقعی منبع و متن اصلی |
| اشخاص و کسبوکارهای کمترشناختهشده | هویت، سوابق و مشخصات |
| قیمتها، رویدادها و شرایط جدید | تاریخ و بهروز بودن اطلاعات |
| قوانین، مالیات و قراردادها | متن رسمی و مقررات معتبر |
| خلاصهسازی فایلها | تطبیق نتیجه با سند اصلی |
| سؤالهای جهتدار | احتمال تأیید فرض اشتباه کاربر |
| درخواست پاسخ خیلی کوتاه برای مسئله پیچیده | حذف توضیحات و ملاحظات ضروری |
در پژوهش Giskard، اجبار بعضی مدلها به پاسخ بسیار کوتاه در برخی آزمونها مقاومت اونها در برابر اطلاعات نادرست رو کاهش داد.
این به معنی اشتباهبودن پاسخهای کوتاه نیست؛ اما برای مسئله پیچیده باید اجازه بدیم توضیحات ضروری ارائه بشن.
آیا هوش مصنوعی قابل اعتماد است؟
بله، اما میزان اعتماد باید متناسب با شواهد، موضوع و پیامد احتمالی اشتباه باشه.
برای مثال، اشتباه در پیشنهاد یک عنوان اینستاگرامی با اشتباه در تفسیر آزمایش پزشکی یا محاسبه مالیات شرکت، پیامد یکسانی نداره.
چرا ممکن است بیشازحد به هوش مصنوعی اعتماد کنیم؟
گفتوگو با چتبات تجربه متفاوتی از جستوجوی معمولی ایجاد میکنه. میتونیم سؤال بپرسیم، توضیح بیشتری بخوایم و جواب شخصیسازیشده دریافت کنیم.
این ارتباط مفیده، اما ممکنه باعث بشه به پاسخی که خوب و قاطع بیان شده، بیشازحد اعتماد کنیم. مطالعات رفتار کاربران هم نشون میدن لحن مطمئن مدل میتونه بر پذیرش پیشنهادهاش اثر بذاره.
از طرفی، همیشه سراغ منبع اصلی نمیریم.
در پژوهش مرکز Pew در سال ۲۰۲۵، کاربران آمریکایی در فقط حدود ۱ درصد بازدیدهای بررسیشده از نتایج گوگل که خلاصه هوش مصنوعی داشتن، روی لینک منابع داخل خلاصه کلیک کردن.
این آمار کاهش قطعی تعداد جستوجوهای گوگل یا اعتماد کامل کاربران به AI رو ثابت نمیکنه؛ اما نشون میده دریافت پاسخ مستقیم، همیشه با بررسی منبع همراه نیست.
پژوهشها درباره دقت هوش مصنوعی چه میگویند؟
دو نتیجه مهم داریم:
- گوگل دیپمایند، دسامبر ۲۰۲۵: در بنچمارک FACTS، بالاترین امتیاز کلی میان مدلهای بررسیشده ۶۸٫۸ درصد بود. این نتیجه مربوط به همون مجموعه آزمونه، نه میزان دقت عمومی تمام ابزارهای هوش مصنوعی.
- EBU و BBC، اکتبر ۲۰۲۵: در بررسی بیش از ۳۰۰۰ پاسخ به سؤالهای خبری، ۴۵ درصد پاسخها دستکم یک مشکل جدی داشتن؛ از جمله ایراد در منبعدهی، دقت اطلاعات یا ارائه زمینه درست.
این پژوهشها نشون میدن دقت پاسخ به موضوع، مدل و روش ارزیابی بستگی داره؛ بنابراین نمیشه یک درصد ثابت برای اعتماد به همه پاسخهای AI تعیین کرد.
چقدر باید پاسخ هوش مصنوعی را بررسی کنیم؟
من در ارزیابی کسبوکارها به یک اصل اعتقاد دارم:
«رزومه ادعاست و باید اعتبارسنجی شود.»
پاسخ هوش مصنوعی هم یک ادعاست. هرچه پیامد اشتباهبودنش بزرگتر باشه، بررسی دقیقتری نیاز داریم.
| نوع استفاده | سطح ریسک معمول | میزان بررسی |
|---|---|---|
| ایدهپردازی، پیشنهاد عنوان و بازنویسی | پایین | بررسی تناسب و کیفیت |
| خلاصه گزارش و پیام به مشتری | متوسط | کنترل اطلاعات، اعداد و تعهدات |
| قیمتگذاری و تحلیلهای مدیریتی | متوسط تا بالا | بررسی دادهها و منابع |
| تصمیمهای پزشکی، حقوقی، مالیاتی و حساس | بالا | تأیید با مدارک معتبر و متخصص مربوط |
این دستهبندی براساس پیامد احتمالی خطاست، نه اینکه همه کارهای یک گروه همیشه ریسک یکسان داشته باشن. حتی یک پیام ساده به مشتری هم اگر وعده نادرستی بده، میتونه خسارت ایجاد کنه.
توهم هوش مصنوعی چه پیامدهایی دارد؟
اطلاعات ساختگی ممکنه از یک گفتوگو خارج بشن و به خسارت مالی، مسئولیت حقوقی یا آسیب به اعتبار یک کسبوکار منجر بشن.
سه پرونده واقعی این موضوع رو نشون میدن.
ایر کانادا؛ وقتی چتبات سیاست شرکت را اشتباه گفت
در سال ۲۰۲۴، یک مسافر براساس پاسخ چتبات ایر کانادا تصور کرد میتونه بعد از خرید بلیت، تخفیف ویژه سوگواری رو درخواست کنه؛ درحالیکه سیاست واقعی شرکت چنین امکانی رو نمیداد.
مرجع رسیدگی در بریتیش کلمبیا، شرکت رو به پرداخت ۸۱۲٫۰۲ دلار کانادا بابت خسارت و هزینهها محکوم کرد.
درس پرونده: کسبوکار نمیتونه صرفاً به این دلیل که اطلاعات نادرست از چتبات صادر شده، مسئولیت پاسخگویی خودش رو نادیده بگیره.
وکلایی که به پروندههای قضایی ساختگی استناد کردند
در سال ۲۰۲۳، دو وکیل آمریکایی در یک لایحه حقوقی به پروندههای قضایی ساختگی تولیدشده توسط ChatGPT استناد کردن.
یکی از وکلا حتی از خود ChatGPT پرسیده بود آیا پرونده معرفیشده واقعیه و پاسخ مثبت گرفته بود.
دادگاه در نهایت وکلا و مؤسسه حقوقی اونها رو مجموعاً به پرداخت ۵۰۰۰ دلار جریمه محکوم کرد.
درس پرونده: تأیید پاسخ توسط همون مدل، جای مراجعه به منبع اصلی و مستقل رو نمیگیره.
دیلویت؛ گزارشی با منابع ناموجود
در سال ۲۰۲۵، مشخص شد گزارشی که دیلویت برای دولت استرالیا تهیه کرده بود، حاوی ارجاعات پژوهشی ناموجود و یک نقلقول ساختگیه.
ارزش قرارداد حدود ۴۴۰ هزار دلار استرالیا بود و دیلویت پذیرفت بخشی از مبلغ رو برگردونه.
نسخه اصلاحشده گزارش اعلام کرد در تهیه اون از Azure OpenAI استفاده شده بود؛ اما دیلویت اعلام نکرد که خطاهای گزارش رو هوش مصنوعی ایجاد کرده.
درس پرونده: استفاده از فناوری یا اعتبار یک شرکت بزرگ، جای کنترل منابع و بررسی تخصصی رو نمیگیره.
تجربه آیپی امداد در پاسخگویی خودکار
این موضوع برای من فقط یک بحث نظری نیست.
در آیپی امداد، برای پاسخگویی خودکار اینستاگرام، قواعد مشخصی تعریف کردیم و اونها رو بندبهبند بررسی کردیم.
مثلاً وقتی مشتری هزینه تعمیر دستگاه رو میپرسه، پاسخگوی خودکار نباید بدون اطلاعات کافی و عیبیابی، مبلغ قطعی اعلام کنه؛ چون قیمت قطعات و خدمات تغییر میکنه و علت خرابی هم هنوز مشخص نیست.
در زمانبندی هم تفاوت مهمی وجود داره. برای درخواستهای ثبتشده، تعهد تماس متخصص جهت هماهنگی حداکثر ۴۵ دقیقه است؛ اما این به معنی حضور متخصص در محل ظرف ۴۵ دقیقه نیست.
اگر چتبات این دو موضوع رو اشتباه بیان کنه، وعدهای به مشتری میده که با تعهد واقعی شرکت تفاوت داره.
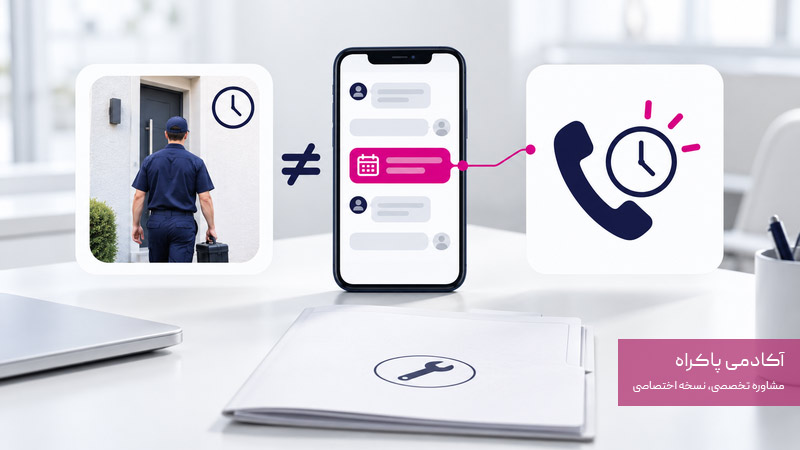
چون اگر یک قانون اشتباه وارد سیستم پاسخگویی بشه، ممکنه همون خطا بارها برای مشتریان مختلف تکرار بشه.
توهم هوش مصنوعی چه تأثیری بر یادگیری و آینده دانش انسانها دارد؟
به نظر من، یکی از جدیترین پیامدهای توهم اینه که اطلاعات اشتباه میتونن به چیزی تبدیل بشن که انسانها اون رو بهعنوان دانش یاد میگیرن.
فرض کن دانشجویی یک مفهوم اقتصادی رو از هوش مصنوعی اشتباه یاد بگیره و همون توضیح رو در تحقیقش استفاده کنه. بعد افراد دیگه هم از اون تحقیق یاد بگیرن.
حالا یک پاسخ نادرست از گفتوگوی اولیه خارج شده و در مسیر انتقال دانش قرار گرفته.
اطلاعات غلط پیش از ظهور هوش مصنوعی هم وجود داشتن؛ اما سرعت تولید محتوا، امکان گفتوگوی مستقیم و مقیاس استفاده از AI میتونن اثر چنین خطاهایی رو گستردهتر کنن.
آیا اطلاعات ساختگی میتوانند وارد آموزش هوش مصنوعیهای بعدی شوند؟
پژوهشی که سال ۲۰۲۴ در مجله Nature منتشر شد، بررسی کرد اگر مدلهای جدید بهصورت مکرر با دادههای تولیدشده توسط مدلهای قبلی آموزش ببینن، چه اتفاقی میافته.
در شرایط بررسیشده، این چرخه باعث افت کیفیت و از دست رفتن بخشی از اطلاعات و تنوع دادههای اصلی شد.
به این پدیده فروپاشی مدل (Model Collapse) گفته میشه.
فروپاشی مدل دقیقاً همون توهم نیست. همچنین این پژوهش ثابت نمیکنه هر محتوای تولیدشده با AI باعث چنین اتفاقی خواهد شد. خطر اصلی در آموزش مکرر و بدون کنترل کیفیت روی دادههای تولیدشده و از دست رفتن ارتباط با دادههای اصلیه.
این یافته یک نگرانی مهم رو روشن میکنه: اگر خروجی مدلها بدون بررسی و مدیریت کیفیت دوباره وارد چرخه آموزش بشه، خطاها و محدودیتهای دادهها میتونن در نسلهای بعدی هم اثر بذارن.
آیا توهم هوش مصنوعی میتواند به فاجعه تبدیل شود؟
نگرانی من درباره آینده اینه که اگر وابستگی انسانها به هوش مصنوعی برای یادگیری و تصمیمگیری بیشتر بشه، اما نظارت و اعتبارسنجی همزمان رشد نکنه، خطاهای این فناوری میتونن پیامدهای جدی و حتی فاجعهباری داشته باشن.
بهخصوص در حوزههایی مثل سلامت، حقوق و مسائل مالی که یک توصیه نادرست ممکنه مستقیماً به زندگی افراد آسیب برسونه.
گوگل در ارزیابی محتوای وب به موضوعات حساس تحت عنوان YMYL (Your Money or Your Life) توجه ویژهای داره؛ یعنی موضوعاتی که اطلاعات نادرست درباره اونها ممکنه به سلامت، امنیت یا وضعیت مالی و رفاه افراد آسیب جدی برسونه.
YMYL یک الگوریتم مستقل یا فیلتر تضمینی تأیید محتوا نیست، اما منطق مهمی داره: هرچه پیامد اشتباه شدیدتر باشه، اعتبار و نظارت بر اطلاعات اهمیت بیشتری پیدا میکنه.
چتباتها هم حفاظتهایی برای پاسخگویی در موضوعات حساس دارن؛ مثلاً ممکنه توصیه کنن کاربر با پزشک یا وکیل مشورت کنه. اما وجود چنین هشداری بهتنهایی صحت باقی پاسخ رو تضمین نمیکنه.
از نظر من، مسئولیت پیشگیری از آسیب فقط با کاربر نیست. توسعهدهندگان باید برای کاهش خطا تلاش کنن، سازمانها باید عملکرد ابزارهای خودشون رو کنترل کنن و کاربران هم باید مهارت راستیآزمایی اطلاعات رو یاد بگیرن.
راهحل کنارگذاشتن هوش مصنوعی نیست؛ ایجاد فرهنگ بررسی و نظارت متناسب با خطره.
چطور توهم هوش مصنوعی را تشخیص دهیم؟
برای تشخیص اطلاعات ساختگی باید ادعاهای مهم رو با شواهد واقعی مقایسه کنیم.
فرض کن برای توسعه کسبوکارت، هوش مصنوعی اعلام میکنه یک بازار در سال گذشته ۳۰ درصد رشد داشته. برای بررسی این ادعا پنج مرحله رو دنبال کن.
۱. ادعای نیازمند بررسی را مشخص کن
اول ببین کدام اطلاعات میتونن روی تصمیمت اثر بذارن؛ مثل عدد، تاریخ، قانون، نام شخص یا نتیجه یک پژوهش.
در مثال ما، عدد ۳۰ درصد، سال و محدوده بازار باید بررسی بشن.
۲. منبع اصلی را پیدا کن
از مدل بخواه منبع رو معرفی کنه. بعد گزارش رو در وبسایت منتشرکننده یا پایگاه معتبر مربوط جستوجو کن.
صرف اینکه یک لینک در پاسخ وجود داره، نشون نمیده منبع واقعی یا معتبره.
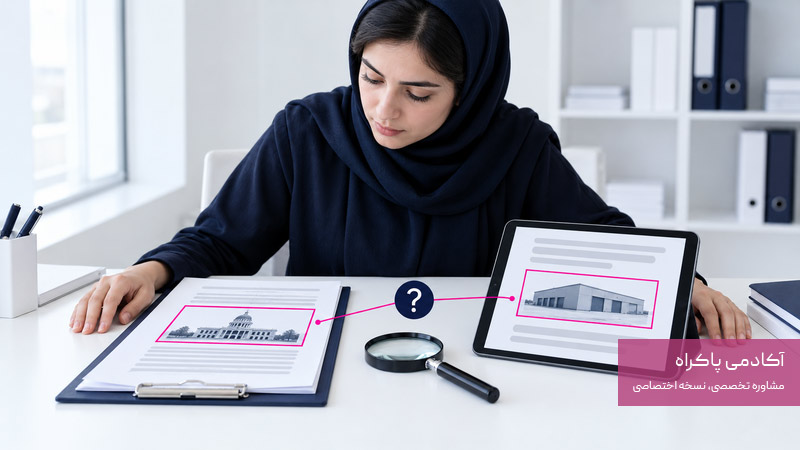
۳. ادعا را با محتوای منبع تطبیق بده
ممکنه گزارش واقعی باشه، اما عدد ۳۰ درصد مربوط به کشور، سال یا بخش متفاوتی از بازار باشه.
پس بررسی کن آیا منبع دقیقاً همون ادعا رو تأیید میکنه یا نه.
۴. برای اطلاعات مهم، تأیید مستقل بگیر
اگر قراره براساس پاسخ تصمیم مهمی بگیری، از مرجع رسمی یا متخصص مربوط کمک بگیر.
میتونی از هوش مصنوعی دیگهای هم کمک بخوای یا یک سؤال رو چند بار مطرح کنی. اختلاف پاسخها میتونه نشانهای برای بررسی بیشتر باشه؛ اما یکسانبودن جوابها، درستی اونها رو ثابت نمیکنه.
۵. اگر شواهد کافی نبود، پاسخ را قطعی ندان
وقتی منبع مناسبی پیدا نمیکنی، ادعا رو بهعنوان واقعیت قطعی منتشر نکن.
«تأییدنشده» با «قطعاً غلط» فرق داره. پیدا نکردن منبع همیشه ثابت نمیکنه اطلاعات نادرستن؛ بلکه یعنی هنوز شواهد کافی برای پذیرش اونها نداریم.
اگر پاسخ براساس فایل یا گزارش داخلی خودته، شماره صفحه، عبارت مرتبط و تطبیق نتیجه با سند اصلی رو هم بررسی کن.
چطور احتمال توهم هوش مصنوعی را کاهش دهیم؟
با درخواست روشن، ارائه اطلاعات معتبر و مشخصکردن حدود پاسخ میتونیم احتمال بعضی خطاها رو کمتر کنیم؛ اما هیچ پرامپتی درستی کامل پاسخها رو تضمین نمیکنه.
۱. اجازه بده بگوید «نمیدانم»
لازم نیست مدل برای تمام سؤالها پاسخ قطعی داشته باشه.
«اگر اطلاعات کافی یا معتبری برای پاسخ نداری، صریح بگو نمیدانم و جزئیات رو حدس نزن.»
این درخواست میتونه به اعلام عدم اطمینان کمک کنه، ولی تضمین نمیکنه مدل همیشه اشتباه خودش رو تشخیص بده.
۲. پاسخ را به سند معتبر محدود کن
اگر قرارداد، گزارش یا دستورالعمل مشخصی داری، اون رو در اختیار مدل بذار.
«فقط براساس فایل ارائهشده پاسخ بده. برای هر ادعا شماره صفحه یا بند و عبارت پشتیبان رو مشخص کن. اگر اطلاعات در فایل نیست، حدس نزن.»
بعد نقلقولها رو با سند اصلی مقایسه کن.
توجه داشته باش که استخراج درست یک بند قرارداد به معنی قانونی یا قابلاجرا بودن اون نیست؛ این موضوع ممکنه نیاز به بررسی حقوقی داشته باشه.
۳. برای ادعاهای مهم، شواهد بخواه
«برای هر آمار یا ادعای مهم، منبع اصلی و تاریخ انتشار رو معرفی کن. ادعاهای بدون پشتوانه قابلبررسی رو قطعی مطرح نکن.»
معرفی منبع فقط قدم اوله؛ باید اون رو باز کنی و بخونی.
۴. سؤال را بیطرفانه مطرح کن
بهجای «چرا تخفیف دائمی بهترین روش افزایش فروش منه؟» بپرس:
«تخفیف دائمی چه مزایا، معایب و ریسکهایی برای فروش، سودآوری و رفتار مشتری داره؟ برای تصمیمگیری به چه اطلاعاتی نیاز داریم؟»
این روش به مدل فرصت میده فرض اولیه تو رو هم بررسی کنه.
۵. برای اطلاعات جدید، منبع بهروز بخواه
برای قیمتها، قوانین، زمان ثبتنام یا رویدادهای جدید، در صورت دسترسی از قابلیت جستوجو استفاده کن.
«شرایط فعلی ثبتنام این آزمون رو از وبسایت رسمی برگزارکننده بررسی کن و تاریخ و نشانی صفحه رو ارائه بده.»
اگر ابزار به اینترنت یا منبع مربوط دسترسی نداره، باید این محدودیت رو مشخص کنه؛ نه اینکه وانمود کنه بررسی انجام شده.
۶. کارهای حساس را به بررسی انسانی وابسته کن
در موضوعات پزشکی، حقوقی، مالی یا پاسخگویی سازمانی، فقط اصلاح پرامپت کافی نیست.
باید حدود اختیارات مدل، اطلاعات مجاز و شرایط ارجاع به متخصص یا مسئول انسانی مشخص باشن.
برای مثال، یک چتبات پشتیبانی نباید بدون اختیار شرکت تعهد جدید ایجاد کنه یا درباره مسئلهای که اطلاعات کافی نداره پاسخ قطعی بده.
۷. برای مسئله پیچیده، پاسخ بیشازحد کوتاه نخواه
اگر موضوع به تحلیل و بررسی استثناها نیاز داره، مدل رو مجبور نکن همهچیز رو در یک جمله توضیح بده.
پژوهش Giskard نشون داد در بعضی آزمونها، محدودیت شدید طول پاسخ با کاهش مقاومت مدل در برابر اطلاعات نادرست همراه بود.
این یعنی پاسخ باید بهاندازهای کامل باشه که توضیحات ضروری حذف نشن؛ نه اینکه لزوماً طولانی نوشته بشه.
جمعبندی: آیا باید به هوش مصنوعی اعتماد کنیم؟
هوش مصنوعی میتونه ابزار مفیدی برای یادگیری، تحقیق و انجام کارها باشه؛ اما نباید پاسخهاش رو فقط بهدلیل بیان روان و قاطع، درست فرض کنیم.
خطر اصلی توهم زمانی بیشتر میشه که اطلاعات ساختگی وارد آموزشها، تصمیمها و باورهای انسانها بشن و بدون بررسی مورد استفاده قرار بگیرن.
به هوش مصنوعی اعتماد کن، اما نه بیشتر از شواهدی که برای درستبودن پاسخهاش داری.
روی دکمه «مشاوره آنلاین» کلیک کنید تا مهندس ایمان پاکراه و تیم آکادمی پاکراه بهصورت آنلاین و کاملاً رایگان راهنماییتان کنند.
مشاوره آنلاین